
O Kimi K3.1 Pro é o primeiro modelo da série K3.1 da Moonshot, e é um Kimi K3 com mais pós-treino. A história de arquitetura que a Moonshot conta não é um modelo-base novo. É mais reinforcement learning, em código, ferramentas e trabalhos longos, em cima do K3. Eles o chamam de seu modelo mais capaz de classe 3T até agora. A Artificial Analysis lista 2,8 trilhões de parâmetros no total e 104 bilhões ativos, com uma janela de 1 milhão de tokens, texto e imagem na entrada.
Dá para chamar agora. Está no Kimi.ai, nos apps de celular, no Kimi Work, no Kimi Code e na API como kimi-k3.1-pro. Há um segundo endpoint, kimi-k3.1-pro-highspeed, que a Moonshot diz rodar a duas ou três vezes a velocidade, para idas e voltas mais curtas. Esse endpoint rápido não tem nota de índice própria. Os pesos, o arquivo para rodar por conta própria, estão prometidos para 4 de novembro. Até esse arquivo ser público, o produto é a API.
A tabela de notas da própria Moonshot está no esforço máximo, com temperature 1.0 e top-p 0.95. A comparação independente abaixo é a medição de lançamento da Artificial Analysis, ao lado do K3 no máximo.
Quarto lugar, e a conta não se moveu
O K3.1 Pro marca 55 no Intelligence Index. É o quarto. O Opus 5.5 no máximo com fallback marca 58. O Sonnet 5.5 no máximo com fallback e o Muse Wonder Full no máximo marcam 56. O K3 no máximo marca 44. O ganho é de 11 pontos.
Uma tarefa do índice custa US$ 1,98. A do K3 custa US$ 2,00. O preço do token caiu um terço, para US$ 2 por milhão de tokens de entrada, US$ 0,20 em cache e US$ 10 de saída. A saída por tarefa subiu 14%, de cerca de 48.000 tokens no K3 para cerca de 55.000. Um token mais barato e uma resposta mais longa caem na mesma fatura. O que mudou foi a nota.
A Artificial Analysis diz que, quando os pesos saírem, este passa a ser o modelo aberto com a nota mais alta no índice, e a distância para a nota proprietária líder encolhe de 12 pontos para 3. Essa frase é sobre o arquivo. Não vale para um download hoje.
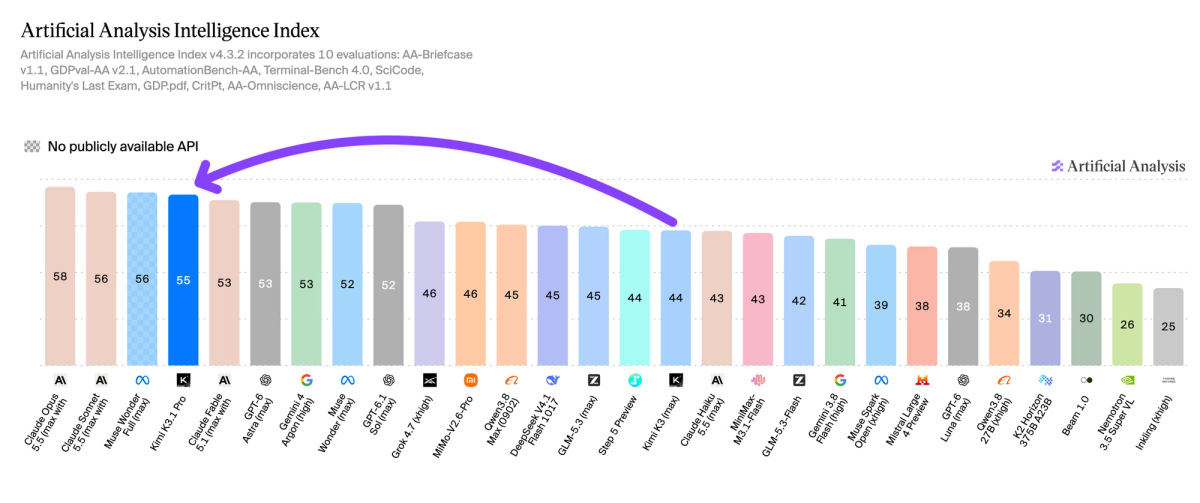
Artificial Analysis. O K3.1 Pro marca 55, atrás do Opus em 58 e atrás do Sonnet e do Muse Wonder Full em 56. O Kimi K3 marca 44.
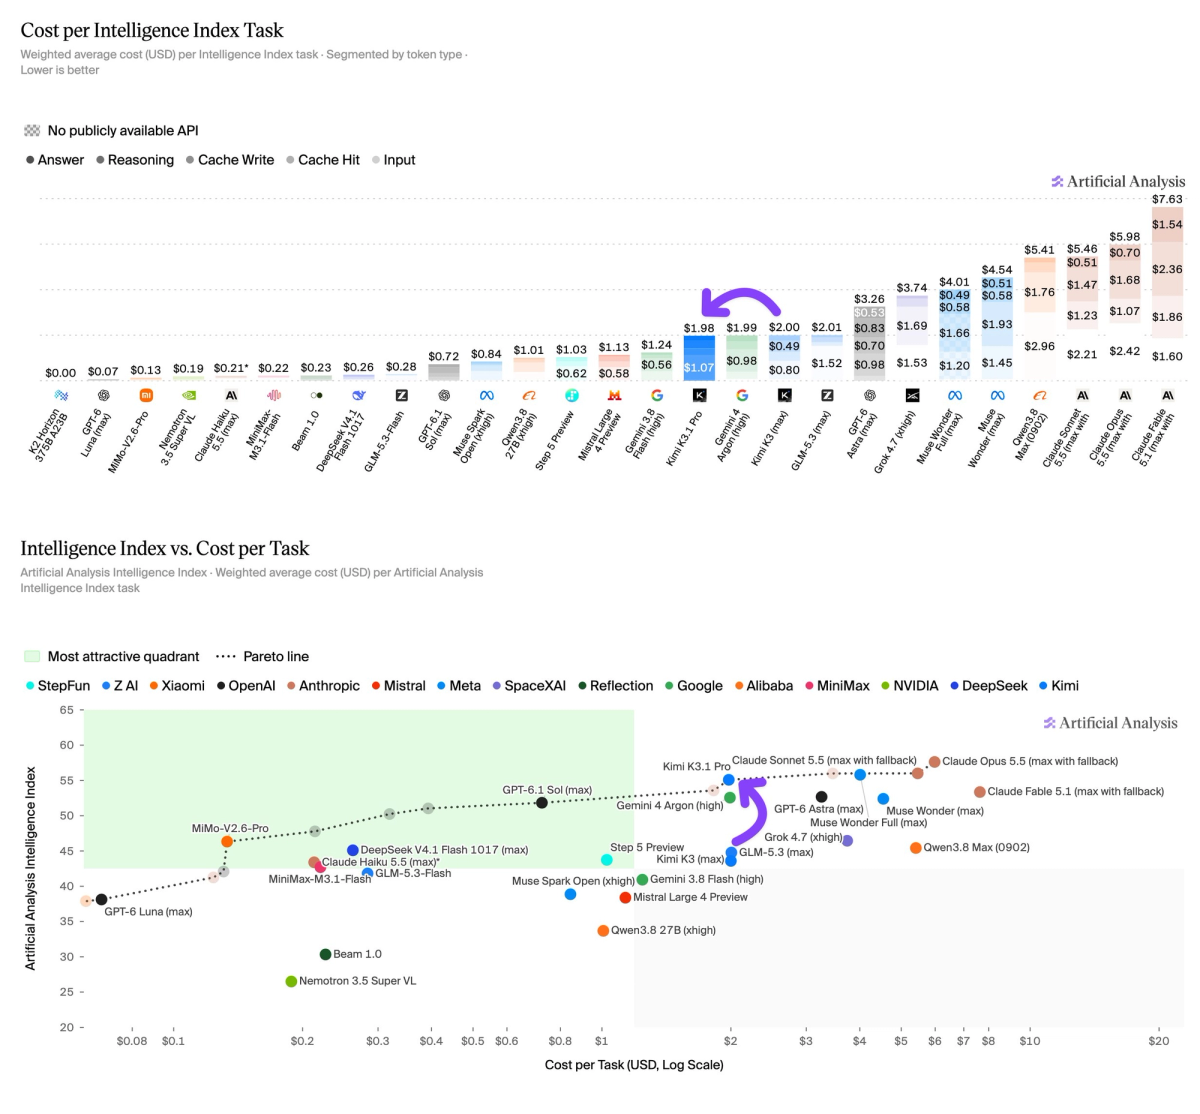
Artificial Analysis. O K3.1 Pro custa US$ 1,98 por tarefa. O Kimi K3 custa US$ 2,00. A nota é 11 pontos mais alta na mesma conta.
De onde vieram os 11 pontos
Vieram dos agentes, não de um salto amplo em todo teste de conhecimento.
No Terminal-Bench 4.0, a Artificial Analysis marca 67%, acima dos 13% do K3, à frente do Sonnet 5.5 em 64%. No AutomationBench-AA, a nota vai de 58% para 73%. No GDPval-AA, o K3.1 Pro é terceiro, com 1.846 Elo, 312 acima do K3, atrás do Opus 5.5 em 1.866 e do Muse Wonder Full em 1.857. É a faixa logo abaixo dos dois modelos no topo do gráfico de trabalho de conhecimento.
O resto do índice move menos. O Humanity's Last Exam vai de 47% para 52%. O CritPt vai de 23% para 25%. O SciCode vai de 59% para 61%. O AA-Omniscience vai de 20 para 30. A alucinação cai de 53% para 44%. A precisão sobe de 48% para 51%. O modelo sabe um pouco mais e inventa um pouco menos. Não alcança os modelos que lideram o Omniscience.
O Terminal-Bench da própria Moonshot, rodado no harness Claude Code, marca 65,7%. Eles colocam isso à frente de uma nota do Astra de 58,2% e logo atrás de uma nota do Opus de 66,4%. Essa tabela mistura a rodada deles com notas publicadas por outros laboratórios. Não é o 67%.
Para o que a Moonshot o construiu
O post de lançamento gasta o comprimento em três trabalhos: código longo, 3D e finanças.
Em código, a Moonshot descreve trabalho que vai de um conserto num repositório existente a um projeto inteiro, incluindo jogos e apps web, com o modelo conduzindo ferramentas em vez de só completar uma função. O bench interno de código de horizonte longo, Kimi Code Bench 3.0, vai de 55,95% no K3 para 61,2%. Esse bench é deles.
Em 3D, a tese é que um briefing em texto, um esboço ou uma imagem de referência bastam para um modelo utilizável, e que o modelo escreve e roda scripts de Blender ou CAD sem um conector MCP. No BenchCAD com ferramentas, reportam 92,7%, contra 96,2% do Opus 5.5 e 95,9% do Astra. Os modelos abertos nessa comparação foram avaliados pela Moonshot numa amostra de 1.000 casos de um conjunto de 17.900. As notas do Opus e do Astra vêm dos relatórios desses laboratórios. O 3D Make, o visualizador no kimi.ai, é a superfície de produto disso, não um benchmark.
Em finanças, reportam 64,4 no OfficeQA Pro v2, que é recuperação e conta sobre documentos reais. O conjunto interno deles se move por deltas, não por uma nota pública: modelagem financeira 7,2 pontos acima do K3, pesquisa financeira 11,6 acima, e uma simulação de operação de negócio em cerca de 4,2 vezes o K3. No teste de estresse de alucinação deles, a taxa de erro por afirmação cai de 23,4% no K3 para 8,3%. A Moonshot diz que esse teste foi feito para provocar erro, e que 8,3% não é a taxa de erro de um dia comum. Também não é o 44% do Omniscience.
O lançamento dos pesos abertos tem uma restrição à parte. A Moonshot diz que dados ligados a cyber saíram do mid-training e da mistura de reinforcement learning antes de esse arquivo ser publicado, e que a capacidade de cyber do modelo aberto fica atrás de modelos proprietários de fronteira que já estão no mercado. A API disponível hoje não é esse arquivo.
Na prática
- Chame kimi-k3.1-pro para o modelo que a Artificial Analysis avaliou. O endpoint rápido é kimi-k3.1-pro-highspeed, nas duas a três vezes de velocidade que a Moonshot cita. Ele não tem um índice separado.
- Leia o 55 como quarto, 11 pontos acima do K3 no máximo. O Opus marca 58. O Sonnet e o Muse Wonder Full marcam 56. Os pesos estão datados de 4 de novembro. O download não é o que dá para fixar hoje.
- Reserve a tarefa a US$ 1,98, ao lado dos US$ 2,00 do K3. O preço do token é um terço mais baixo, a US$ 2, US$ 0,20 em cache e US$ 10. As respostas são cerca de 14% mais longas, perto de 55.000 tokens de saída por tarefa. A tabela publicada da Moonshot usa esforço máximo.
- Em agentes, use o Terminal-Bench da Artificial Analysis em 67%, vindo de 13%, à frente do Sonnet em 64%. A rodada da Moonshot no Claude Code é 65,7%. O GDPval em 1.846 Elo é terceiro, atrás do Opus em 1.866 e do Muse Wonder Full em 1.857. O AutomationBench-AA vai de 58% para 73%.
- Em conhecimento, espere um movimento menor. O Omniscience vai de 20 para 30. A alucinação vai de 53% para 44%. A precisão vai de 48% para 51%. Os 8,3% da Moonshot são o teste de estresse deles, não este.
- Mantenha o BenchCAD em 92,7% e o OfficeQA Pro v2 em 64,4 na coluna da Moonshot, com a amostra e o harness que eles nomeiam. O 55, os US$ 1,98 e os 67% são da Artificial Analysis.
Fontes: Introducing Kimi K3.1 Pro e a Artificial Analysis. O índice de 55, a tarefa de US$ 1,98, os 55.000 tokens de saída, o Terminal-Bench em 67%, o AutomationBench-AA, o GDPval em 1.846 e as taxas de Omniscience são da Artificial Analysis. Os ids da API, o preço de US$ 2 / US$ 0,20 / US$ 10, os pesos de 4 de novembro, o Terminal-Bench de 65,7%, o BenchCAD, o OfficeQA e os deltas internos são da Moonshot. Os 2,8 trilhões no total e os 104 bilhões de parâmetros ativos são da Artificial Analysis.
