
Kimi K3.1 Pro es el primer modelo de la serie K3.1 de Moonshot, y es un Kimi K3 con más post-entrenamiento. La historia de arquitectura que cuenta Moonshot no es un modelo base nuevo. Es más reinforcement learning, en código, herramientas y trabajos largos, encima de K3. Lo llaman su modelo más capaz de clase 3T hasta ahora. Artificial Analysis lista 2,8 billones de parámetros en total y 104.000 millones activos, con una ventana de 1 millón de tokens, texto e imagen de entrada.
Se puede llamar ahora. Está en Kimi.ai, en las apps móviles, en Kimi Work, en Kimi Code y en la API como kimi-k3.1-pro. Hay un segundo endpoint, kimi-k3.1-pro-highspeed, que Moonshot dice que corre a dos o tres veces la velocidad, para idas y vueltas más cortas. Ese endpoint rápido no tiene nota de índice propia. Los pesos, el archivo para ejecutarlo por cuenta propia, están prometidos para el 4 de noviembre. Hasta que ese archivo sea público, el producto es la API.
La tabla de notas de la propia Moonshot está en esfuerzo máximo, con temperature 1.0 y top-p 0.95. La comparación independiente de abajo es la medición de lanzamiento de Artificial Analysis, junto a K3 al máximo.
Cuarto puesto, y la factura no se movió
K3.1 Pro marca 55 en el Intelligence Index. Es el cuarto. Opus 5.5 al máximo con fallback marca 58. Sonnet 5.5 al máximo con fallback y Muse Wonder Full al máximo marcan 56. K3 al máximo marca 44. La ganancia es de 11 puntos.
Una tarea del índice cuesta US$ 1,98. La de K3 cuesta US$ 2,00. El precio del token bajó un tercio, a US$ 2 por millón de tokens de entrada, US$ 0,20 en caché y US$ 10 de salida. La salida por tarea subió un 14%, de unos 48.000 tokens en K3 a unos 55.000. Un token más barato y una respuesta más larga caen en la misma factura. Lo que cambió fue la nota.
Artificial Analysis dice que, cuando salgan los pesos, este pasa a ser el modelo abierto con la nota más alta del índice, y la distancia hasta la nota propietaria líder se reduce de 12 puntos a 3. Esa frase es sobre el archivo. No vale para una descarga hoy.
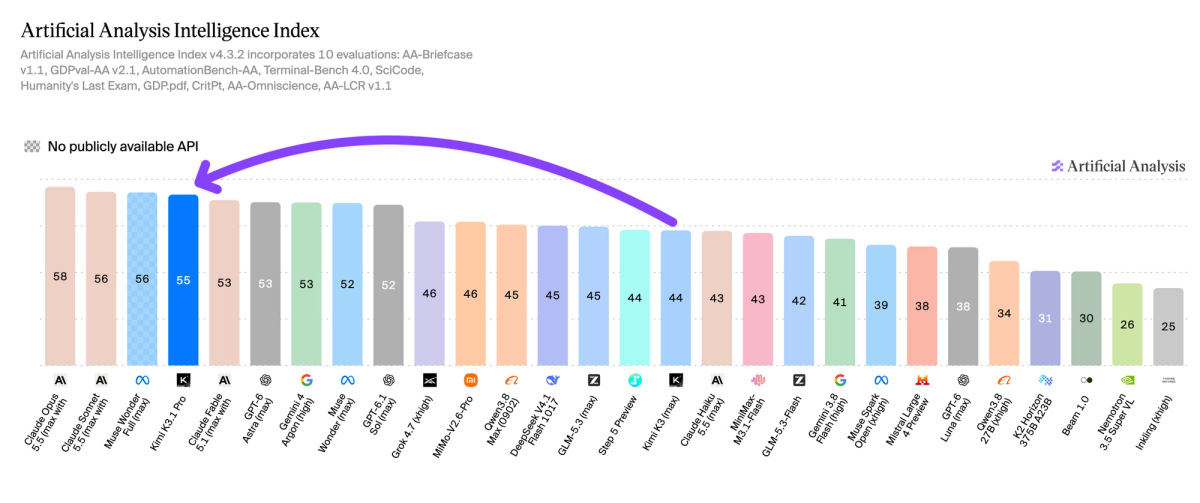
Artificial Analysis. K3.1 Pro marca 55, detrás de Opus en 58 y detrás de Sonnet y Muse Wonder Full en 56. Kimi K3 marca 44.
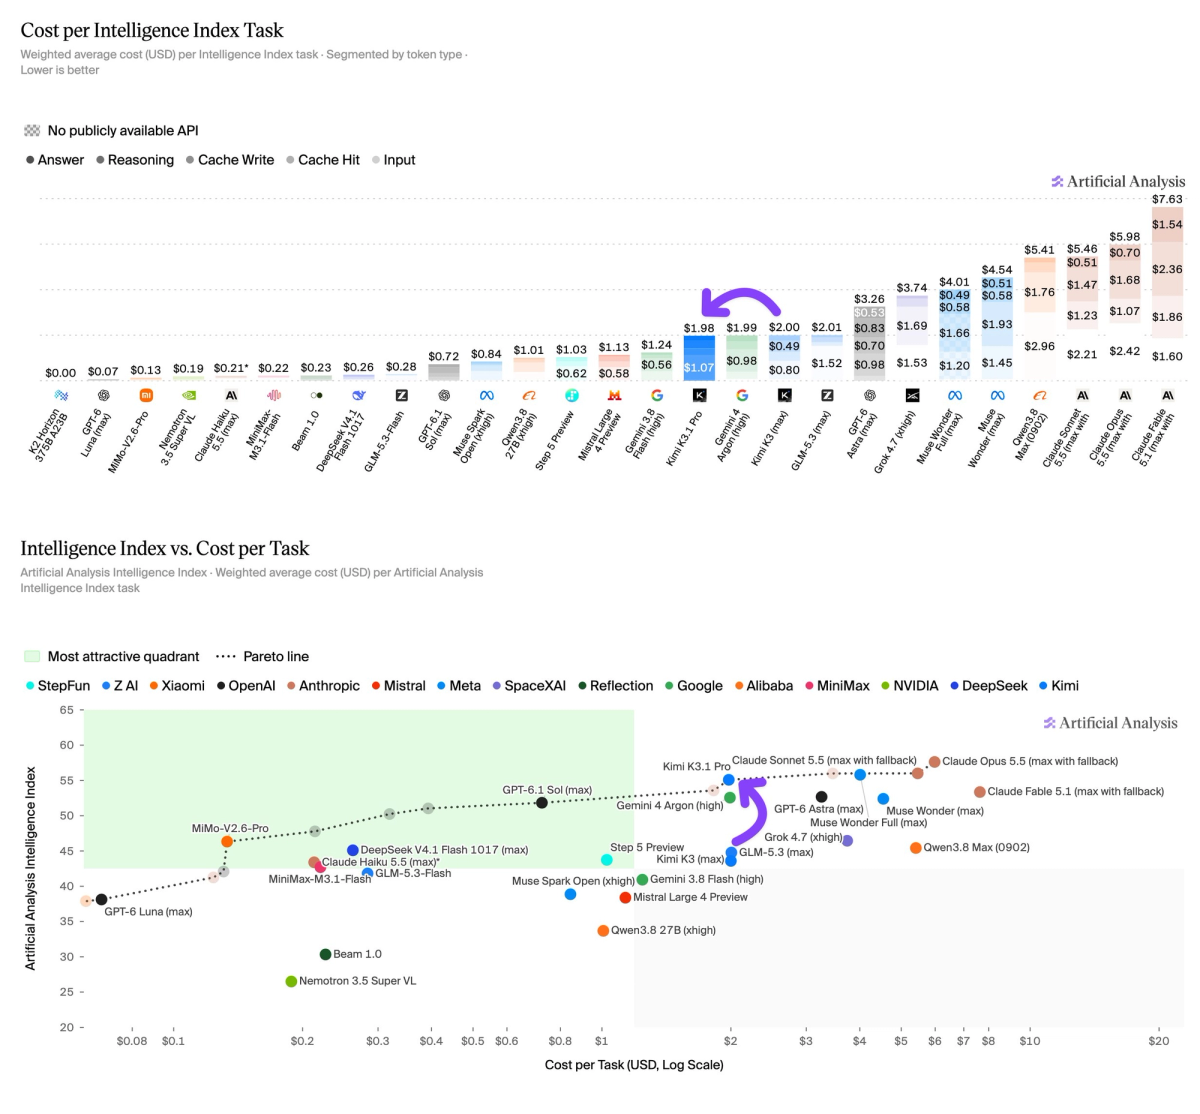
Artificial Analysis. K3.1 Pro cuesta US$ 1,98 por tarea. Kimi K3 cuesta US$ 2,00. La nota es 11 puntos más alta en la misma factura.
De dónde salieron los 11 puntos
Salieron de los agentes, no de un salto amplio en cada prueba de conocimiento.
En Terminal-Bench 4.0, Artificial Analysis marca 67%, por encima del 13% de K3, por delante de Sonnet 5.5 en 64%. En AutomationBench-AA, la nota pasa del 58% al 73%. En GDPval-AA, K3.1 Pro es tercero, con 1.846 Elo, 312 por encima de K3, detrás de Opus 5.5 en 1.866 y de Muse Wonder Full en 1.857. Es la franja justo debajo de los dos modelos en lo alto del gráfico de trabajo de conocimiento.
El resto del índice se mueve menos. Humanity's Last Exam pasa del 47% al 52%. CritPt pasa del 23% al 25%. SciCode pasa del 59% al 61%. AA-Omniscience pasa de 20 a 30. La alucinación baja del 53% al 44%. La precisión sube del 48% al 51%. El modelo sabe un poco más e inventa un poco menos. No alcanza a los modelos que lideran Omniscience.
El Terminal-Bench de la propia Moonshot, corrido en el harness Claude Code, marca 65,7%. Lo ponen por delante de una nota de Astra de 58,2% y justo detrás de una nota de Opus de 66,4%. Esa tabla mezcla su pasada con notas publicadas por otros laboratorios. No es el 67%.
Para qué lo construyó Moonshot
El post de lanzamiento gasta la extensión en tres trabajos: código largo, 3D y finanzas.
En código, Moonshot describe un trabajo que va de un arreglo en un repositorio existente a un proyecto entero, incluidos juegos y apps web, con el modelo conduciendo herramientas en lugar de solo completar una función. Su bench interno de código de horizonte largo, Kimi Code Bench 3.0, pasa del 55,95% en K3 al 61,2%. Ese bench es suyo.
En 3D, la tesis es que un briefing en texto, un boceto o una imagen de referencia bastan para un modelo utilizable, y que el modelo escribe y ejecuta scripts de Blender o CAD sin un conector MCP. En BenchCAD con herramientas, reportan 92,7%, frente a 96,2% de Opus 5.5 y 95,9% de Astra. Los modelos abiertos de esa comparación los evaluó Moonshot en una muestra de 1.000 casos de un conjunto de 17.900. Las notas de Opus y Astra vienen de los informes de esos laboratorios. 3D Make, el visor en kimi.ai, es la superficie de producto de esto, no un benchmark.
En finanzas, reportan 64,4 en OfficeQA Pro v2, que es recuperación y cálculo sobre documentos reales. Su conjunto interno se mueve por deltas, no por una nota pública: modelado financiero 7,2 puntos por encima de K3, investigación financiera 11,6 por encima, y una simulación de operación de negocio en cerca de 4,2 veces K3. En su prueba de estrés de alucinación, la tasa de error por afirmación baja del 23,4% en K3 al 8,3%. Moonshot dice que esa prueba está hecha para provocar errores, y que el 8,3% no es la tasa de error de un día normal. Tampoco es el 44% de Omniscience.
El lanzamiento de los pesos abiertos tiene una restricción aparte. Moonshot dice que los datos ligados a ciberseguridad salieron del mid-training y de la mezcla de reinforcement learning antes de que se publique ese archivo, y que la capacidad de ciberseguridad del modelo abierto queda detrás de modelos propietarios de frontera que ya están en el mercado. La API disponible hoy no es ese archivo.
En la práctica
- Llama a kimi-k3.1-pro para el modelo que evaluó Artificial Analysis. El endpoint rápido es kimi-k3.1-pro-highspeed, a las dos o tres veces de velocidad que cita Moonshot. No tiene un índice separado.
- Lee el 55 como cuarto, 11 puntos por encima de K3 al máximo. Opus marca 58. Sonnet y Muse Wonder Full marcan 56. Los pesos están fechados el 4 de noviembre. La descarga no es lo que se puede fijar hoy.
- Reserva la tarea a US$ 1,98, junto a los US$ 2,00 de K3. El precio del token es un tercio más bajo, a US$ 2, US$ 0,20 en caché y US$ 10. Las respuestas son cerca de un 14% más largas, cerca de 55.000 tokens de salida por tarea. La tabla publicada de Moonshot usa esfuerzo máximo.
- En agentes, usa el Terminal-Bench de Artificial Analysis en 67%, desde el 13%, por delante de Sonnet en 64%. La pasada de Moonshot en Claude Code es 65,7%. GDPval en 1.846 Elo es tercero, detrás de Opus en 1.866 y de Muse Wonder Full en 1.857. AutomationBench-AA pasa del 58% al 73%.
- En conocimiento, espera un movimiento menor. Omniscience pasa de 20 a 30. La alucinación pasa del 53% al 44%. La precisión pasa del 48% al 51%. El 8,3% de Moonshot es su prueba de estrés, no esta.
- Mantén BenchCAD en 92,7% y OfficeQA Pro v2 en 64,4 en la columna de Moonshot, con la muestra y el harness que nombran. El 55, los US$ 1,98 y el 67% son de Artificial Analysis.
Fuentes: Introducing Kimi K3.1 Pro y Artificial Analysis. El índice de 55, la tarea de US$ 1,98, los 55.000 tokens de salida, Terminal-Bench en 67%, AutomationBench-AA, GDPval en 1.846 y las tasas de Omniscience son de Artificial Analysis. Los ids de la API, el precio de US$ 2 / US$ 0,20 / US$ 10, los pesos del 4 de noviembre, el Terminal-Bench del 65,7%, BenchCAD, OfficeQA y los deltas internos son de Moonshot. Los 2,8 billones en total y los 104.000 millones de parámetros activos son de Artificial Analysis.
