
GPT-6.1 Terra es el modelo de volumen de la línea actual de OpenAI. Sol es el que queda al lado de Astra. Astra es la cima. Terra es el que tiene precio para que un desarrollador repita el mismo tipo de trabajo muchas veces: leer una pila de facturas, rellenar un formulario, marcar un dibujo, redactar la nota que va con él. OpenAI lo lanzó el 26 de octubre de 2026, en ChatGPT Work y Codex para Plus, Pro, Enterprise y Edu, y en la API como gpt-6.1-terra.
Recibe texto e imagen y devuelve texto. Amazon Bedrock lista un contexto de 1.050.000 tokens y una salida máxima de 128.000. Artificial Analysis lista una ventana de 1 millón de tokens. El trabajo que señala OpenAI es visual y operativo: un dibujo técnico, una app de escritorio, un documento, una edición de vídeo. La escritura entra en la misma afirmación. OpenAI describe el texto como más claro que el de GPT-5.6 Terra, el Terra anterior.
El precio del token es la otra mitad del producto. El precio estándar de la API es US$ 1 por millón de tokens de entrada, US$ 0,05 en caché y US$ 5 de salida. Sol cuesta US$ 2 y US$ 10. GPT-5.6 Terra costaba US$ 2 y US$ 12. La escritura de caché cuesta US$ 1,25, la mitad del Terra anterior. La entrada en caché es un cuarto de lo que era, US$ 0,05 frente a US$ 0,20. En ChatGPT Work y Codex, OpenAI dice que la misma franquicia de uso cubre más tareas que en GPT-5.6 Terra, y bastante más que en Sol o Astra. La tarifa global de Bedrock acompaña el precio de US$ 1 y US$ 5 hasta 272.000 tokens de entrada, y sube por encima. La tarifa in-region añade una tasa sobre el precio de OpenAI.
La mitad del precio, cuatro puntos detrás
Con esfuerzo máximo, Artificial Analysis marca Terra en 48 en el Intelligence Index. Son 6 puntos por encima de GPT-5.6 Terra, 4 puntos detrás de Sol y 10 puntos por encima de Luna. Una tarea del índice al máximo cuesta US$ 0,40, frente a US$ 1,40 de GPT-5.6 Terra al máximo. Menos de un tercio de la factura antigua, con una nota más alta.
El ajuste que se elige cuando se quiere el modelo barato no es max. Low y medium son los que quedan en la frontera de coste. High, xhigh y max quedan detrás de esa línea: se paga más por punto que otro modelo que ya está en el gráfico. La ganancia sobre GPT-5.6 Terra también es mayor ahí abajo, entre 7 y 13 puntos, que los 6 puntos al máximo.
| Esfuerzo | Intelligence Index | Coste por tarea del índice |
|---|---|---|
| Low | 36 | US$ 0,05 |
| Medium | 41 | US$ 0,10 |
| High | 44 | US$ 0,13 |
| Xhigh | 45 | US$ 0,19 |
| Max | 48 | US$ 0,40 |
En el mismo gráfico, Opus 5.5 marca 58, Sonnet 5.5 y Muse Wonder Full marcan 56, Kimi K3.1 Pro marca 55, y Astra y Gemini 4 Argon marcan 53. Sol marca 52. Terra al máximo queda un paso detrás de Sol. Terra en medium, 41 por US$ 0,10, es otro producto respecto al número de una diapositiva de lanzamiento que usó max.
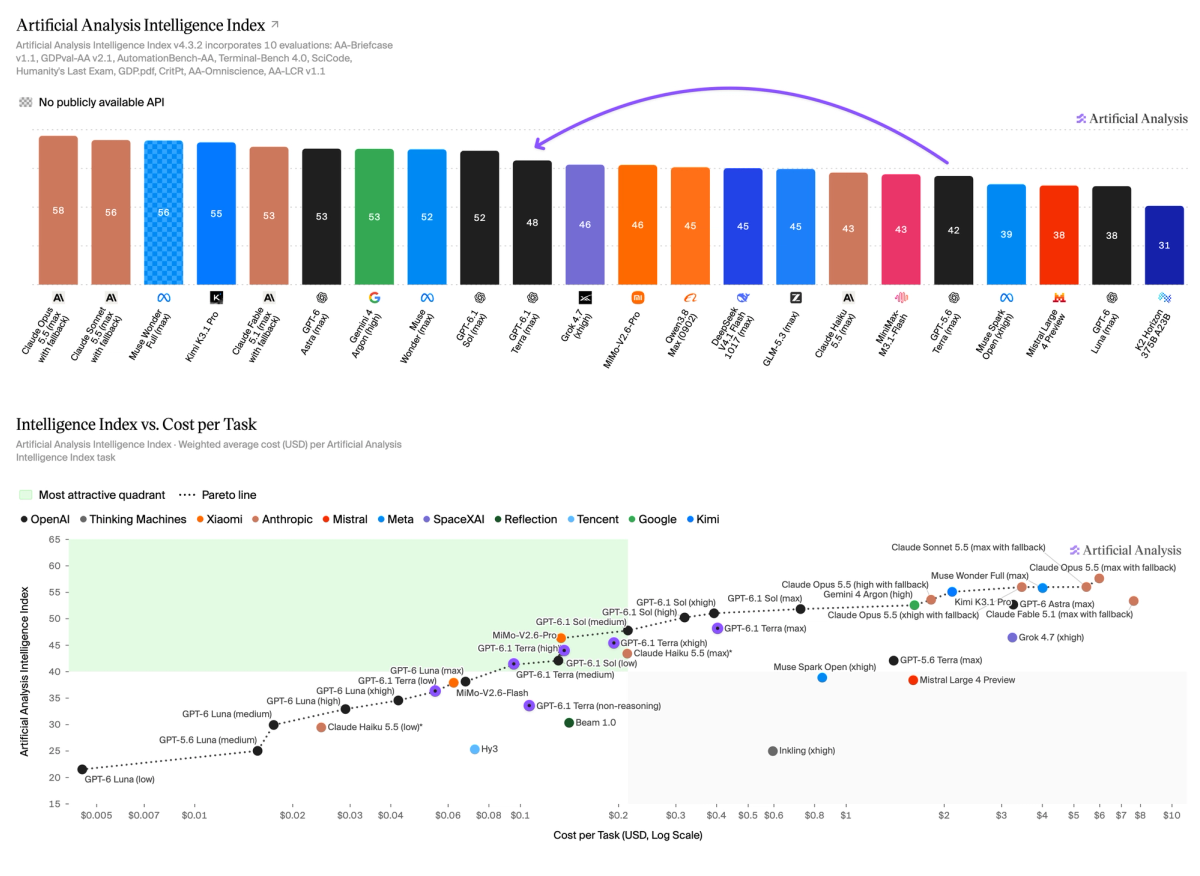
Artificial Analysis. El máximo marca 48, cuatro puntos detrás de Sol. En el gráfico de coste, low y medium quedan en la frontera. El máximo queda detrás.
El otro 48 es una nota de código
El Coding Agent Index v2.0 también marca Terra en 48. Ese índice es FrontierCode, Terminal-Bench 4.0 y SWE-Atlas. No es el Intelligence Index, aunque el número coincida. El 48 de Terra aquí es en Codex. Sol en Codex marca 54. Luna en Codex marca 31. Los modelos de Claude en el mismo gráfico están en Claude Code. Un 48 en Codex no supera una nota de Claude Code, y no significa que la nota de inteligencia y la nota de código sean el mismo resultado.
La frontera se da la vuelta. En este gráfico de código, low y xhigh son los ajustes en la línea de coste. Medium, high y max quedan detrás. En el gráfico de inteligencia, low y medium eran la frontera, y xhigh no lo era. El ajuste barato de código y el ajuste barato general no son el mismo control.
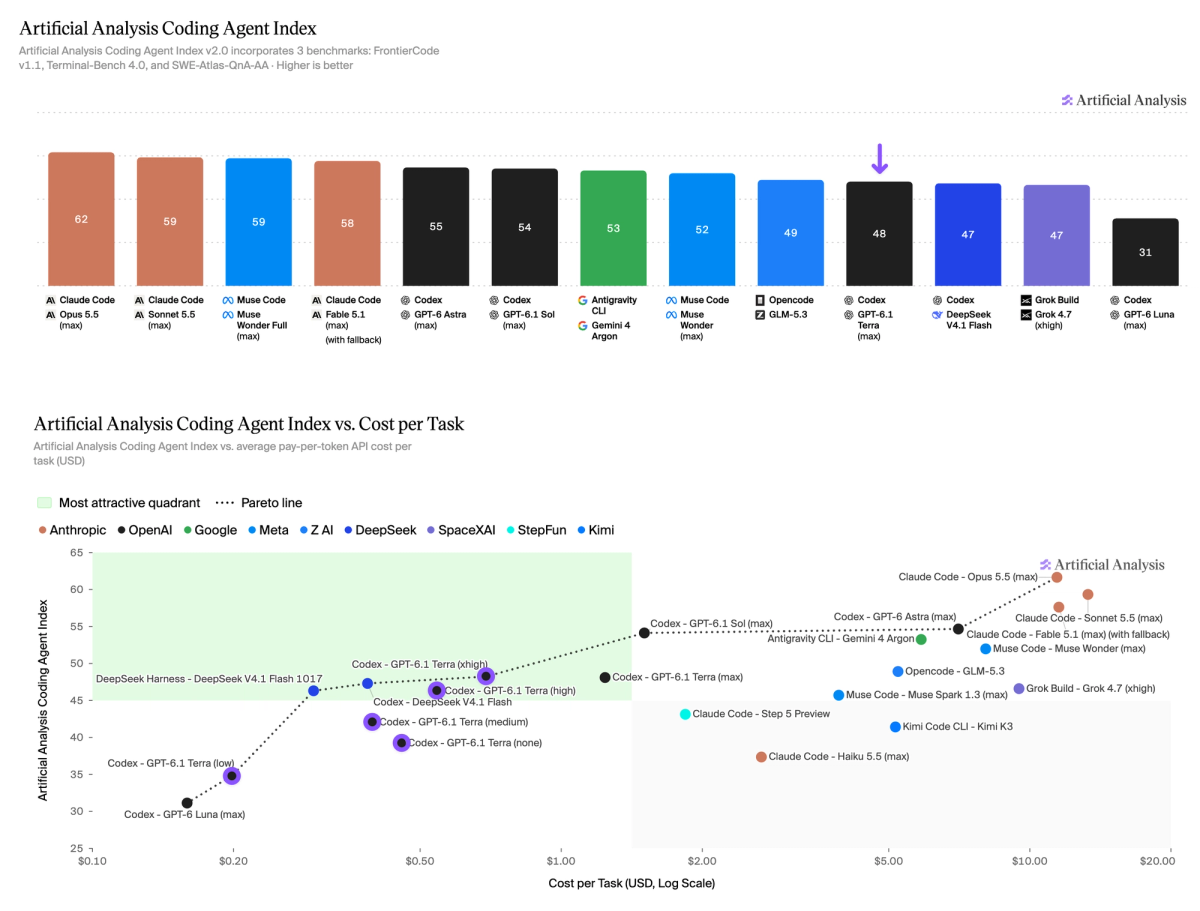
Artificial Analysis. Terra al máximo marca 48 en Codex, seis puntos detrás de Sol en Codex. Low y xhigh son los puntos en esta frontera de coste.
La línea de código de la propia OpenAI es más estrecha, y coincide con el ranking. Al máximo, en el Terminal-Bench 4.0 de OpenAI, Terra resuelve el 50,3% de las tareas, más del doble del 21,5% de GPT-5.6 Terra. OpenAI dice que Sol y Astra siguen siendo la mejor opción para el código más difícil. En Terminal-Bench-Science 0.1, OpenAI dice que Terra al máximo supera a Sol a un coste menor y queda a menos de cinco puntos de Opus 5.5, a menos de un quinto del coste estimado. Esas son las pasadas de OpenAI. No son el gráfico de Artificial Analysis.
En ese gráfico, la ganancia de Terra es de unos 20 puntos, al nivel de Sol al máximo. Kimi K3.1 Pro lidera, con 67%.
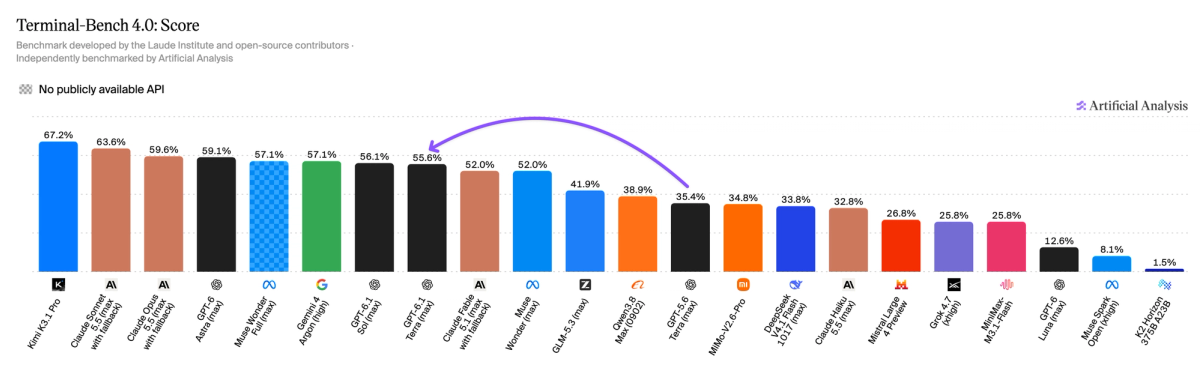
Artificial Analysis. Terra queda junto a Sol. Kimi K3.1 Pro lidera. GPT-5.6 Terra queda bastante detrás.
El uso del ordenador es la tesis del lanzamiento, y está en medium
El caso de OpenAI para Terra no es el índice. Es el uso del ordenador: convertir un dibujo en un modelo, recorrer una app de escritorio, registrar una película plano a plano. La comparación publicada ahí es con esfuerzo medium, en Agents' Last Exam. Terra marca 15 puntos por encima de GPT-5.6 Terra a cerca de un tercio del coste, y OpenAI lo pone al nivel de Astra a un décimo del precio del token. Al máximo, OpenAI dice que Terra es más de tres veces más eficiente en tokens que Opus 5.5, a un cuarto del precio por token, lo que juntan en cerca de nueve veces menos coste por tarea. También dicen que las tareas terminan más de tres veces más rápido que en Astra y Sol.
El post no publica la nota de Agents' Last Exam debajo de esa diferencia de 15 puntos. OSWorld 2.1, en medium, se describe igual: por delante de la mejor nota de GPT-5.6 Terra, a una fracción del coste, sin porcentaje en el post. En MMMU-Pro, razonamiento visual, Terra supera a GPT-5.6 Terra en todos los esfuerzos que muestra OpenAI, y dicen que se acerca a Astra y Sol. Otra vez, sin porcentaje en el post.
Trata ese bloque como el relato de OpenAI sobre el trabajo para el que existe Terra. El número independiente al lado sigue siendo el índice: medium es 41 a US$ 0,10, y ese es el esfuerzo que OpenAI usó en la comparación de uso del ordenador.
Inventa menos, en dos pruebas distintas
En AA-Omniscience, la tasa de alucinación baja del 88% en GPT-5.6 Terra al 38%. La precisión sube 2 puntos. GDP.pdf, dentro del índice, se mueve 5 puntos. La mayor parte del resto de evaluaciones del índice se mueve menos que Terminal-Bench.
OpenAI tiene un segundo conjunto de factualidad, interno, hecho de prompts que tienden a inducir error. Con esfuerzo low, la tasa de error baja del 53,6% al 16,7%. Al máximo baja 18 puntos, al 4,3%, que OpenAI pone junto a Astra y Sol. Ese 4,3% no es el 38%. Uno es el conjunto de error de OpenAI. El otro es la tasa de Artificial Analysis de adivinar cuando el modelo no sabe.
OpenAI también dice que Terra es más propenso que GPT-5.6 Terra a quedarse dentro de la tarea y a decir cuándo algo bloquea, y que resiste la prompt injection en sus pruebas. En ciberseguridad alcanza el umbral Critical del Preparedness Framework de OpenAI, con la misma clase de protecciones que Astra. Eso es una clasificación, no un modo de hacerlo.
En la práctica
- Llama a gpt-6.1-terra cuando el trabajo es uso del ordenador y documento repetidos, y el precio del token importa. El precio de lista es US$ 1, US$ 0,05 en caché y US$ 5. La escritura de caché cuesta US$ 1,25. Sol sigue en US$ 2 y US$ 10.
- Usa medium para la tesis de uso del ordenador que está haciendo OpenAI. Esa comparación es 15 puntos por encima de GPT-5.6 Terra a cerca de un tercio del coste. Medium en el índice es 41, a US$ 0,10 por tarea. Low es 36, a US$ 0,05. Esos dos son los que quedan en la frontera de inteligencia y coste.
- Lee el máximo como 48, cuatro puntos detrás de Sol, a US$ 0,40 por tarea. Son 6 puntos por encima de GPT-5.6 Terra y menos de un tercio de los US$ 1,40 de ese modelo. High es 44 a US$ 0,13. Xhigh es 45 a US$ 0,19. En el gráfico de inteligencia, esos tres quedan detrás de la frontera.
- En agentes de código, separa el control. Low y xhigh son los ajustes de frontera en el Coding Agent Index. El 48 de Terra ahí es Codex, seis puntos detrás de los 54 de Sol en Codex. El Terminal-Bench de la propia OpenAI al máximo es 50,3%, frente al 21,5% de GPT-5.6 Terra. Artificial Analysis pone a Terra junto a Sol, con Kimi K3.1 Pro en 67% por delante de los dos. Para el código más difícil, OpenAI sigue señalando a Sol y Astra.
- Mantén los números de factualidad cada uno en su prueba. La alucinación en Omniscience es 38%, desde el 88%, con la precisión 2 puntos por encima. La tasa de error interna de OpenAI es 16,7% en low y 4,3% al máximo.
- Un prompt largo en Bedrock cambia el precio. Hasta 272.000 tokens de entrada, la tarifa global acompaña a OpenAI. Por encima, Bedrock sube. El contexto que lista Bedrock es de 1.050.000 tokens, con 128.000 tokens de salida máxima.
Fuentes: Introducing GPT-6.1 Terra, Artificial Analysis y la model card de Bedrock. La escalera del índice, la tarea de US$ 0,40, el Coding Agent Index, las tasas de Omniscience y el gráfico de Terminal-Bench son de Artificial Analysis. El precio de US$ 1 / US$ 0,05 / US$ 5, la comparación de Agents' Last Exam, el Terminal-Bench del 50,3%, Terminal-Bench-Science, MMMU-Pro, OSWorld y las tasas de error internas son de OpenAI. La ventana de 1.050.000 tokens y el escalón de precio de Bedrock son de AWS.
