
O GPT-6.1 Terra é o modelo de volume da linha atual da OpenAI. O Sol é o que fica ao lado do Astra. O Astra é o topo. O Terra é o que tem preço para o desenvolvedor repetir o mesmo tipo de trabalho muitas vezes: ler uma pilha de faturas, preencher um formulário, marcar um desenho, redigir a nota que vai junto. A OpenAI lançou em 26 de outubro de 2026, no ChatGPT Work e no Codex para Plus, Pro, Enterprise e Edu, e na API como gpt-6.1-terra.
Ele recebe texto e imagem e devolve texto. A Amazon Bedrock lista um contexto de 1.050.000 tokens e uma saída máxima de 128.000. A Artificial Analysis lista uma janela de 1 milhão de tokens. O trabalho que a OpenAI aponta é visual e operacional: um desenho técnico, um app de desktop, um documento, uma edição de vídeo. A escrita entra na mesma afirmação. A OpenAI descreve o texto como mais claro do que o do GPT-5.6 Terra, o Terra anterior.
O preço do token é a outra metade do produto. O preço padrão da API é US$ 1 por milhão de tokens de entrada, US$ 0,05 em cache e US$ 5 de saída. O Sol custa US$ 2 e US$ 10. O GPT-5.6 Terra custava US$ 2 e US$ 12. A escrita de cache custa US$ 1,25, metade do Terra anterior. A entrada em cache é um quarto do que era, US$ 0,05 contra US$ 0,20. No ChatGPT Work e no Codex, a OpenAI diz que a mesma franquia de uso cobre mais tarefas do que no GPT-5.6 Terra, e bem mais do que no Sol ou no Astra. A tarifa global da Bedrock acompanha o preço de US$ 1 e US$ 5 até 272.000 tokens de entrada, e sobe acima disso. A tarifa in-region acrescenta uma taxa por cima do preço da OpenAI.
Metade do preço, quatro pontos atrás
No esforço máximo, a Artificial Analysis marca o Terra em 48 no Intelligence Index. São 6 pontos acima do GPT-5.6 Terra, 4 pontos atrás do Sol e 10 pontos acima da Luna. Uma tarefa do índice no máximo custa US$ 0,40, contra US$ 1,40 do GPT-5.6 Terra no máximo. Menos de um terço da conta antiga, com uma nota mais alta.
O ajuste que se escolhe quando se quer o modelo barato não é o max. Low e medium são os que ficam na fronteira de custo. High, xhigh e max ficam atrás dessa linha: paga-se mais por ponto do que outro modelo que já está no gráfico. O ganho sobre o GPT-5.6 Terra também é maior ali embaixo, entre 7 e 13 pontos, do que os 6 pontos no máximo.
| Esforço | Intelligence Index | Custo por tarefa do índice |
|---|---|---|
| Low | 36 | US$ 0,05 |
| Medium | 41 | US$ 0,10 |
| High | 44 | US$ 0,13 |
| Xhigh | 45 | US$ 0,19 |
| Max | 48 | US$ 0,40 |
No mesmo gráfico, o Opus 5.5 marca 58, o Sonnet 5.5 e o Muse Wonder Full marcam 56, o Kimi K3.1 Pro marca 55, e o Astra e o Gemini 4 Argon marcam 53. O Sol marca 52. O Terra no máximo fica um passo atrás do Sol. O Terra no medium, 41 por US$ 0,10, é outro produto em relação ao número de um slide de lançamento que usou o max.
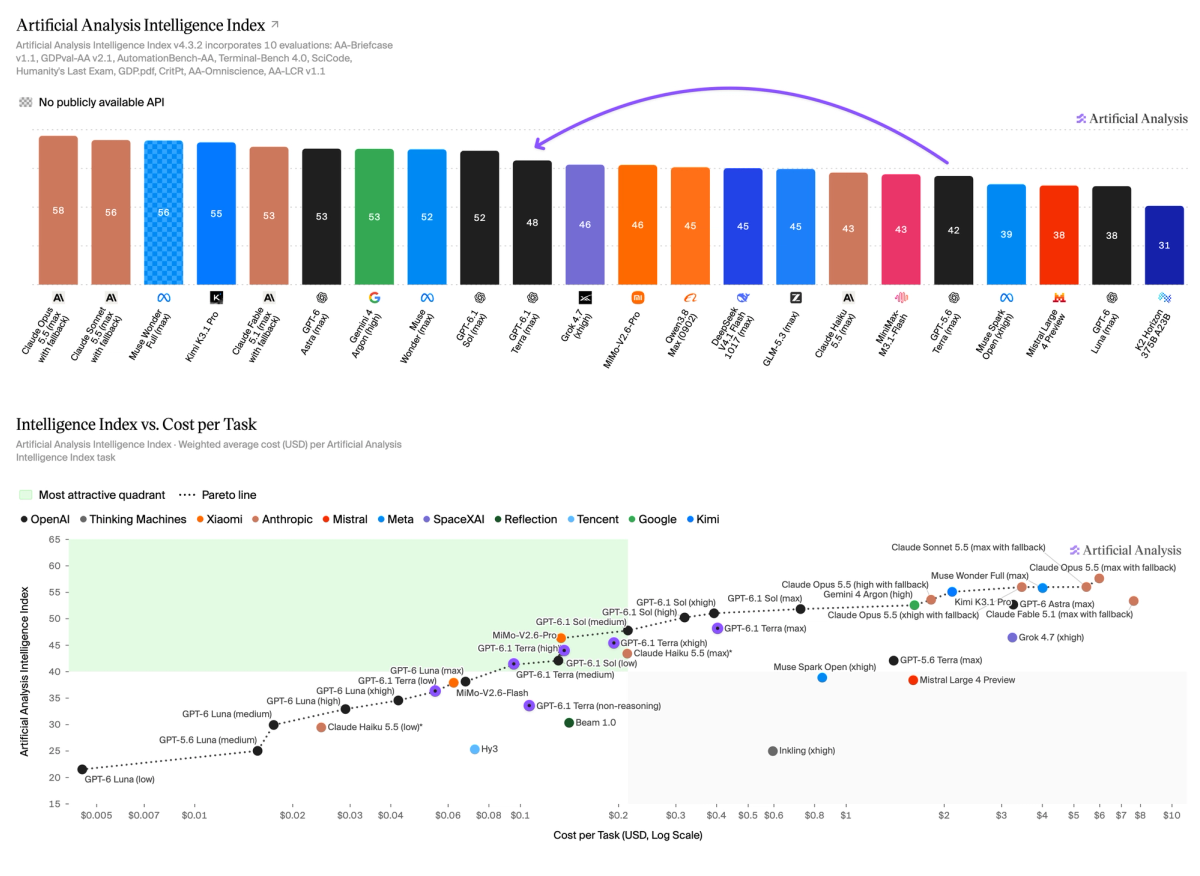
Artificial Analysis. O máximo marca 48, quatro pontos atrás do Sol. No gráfico de custo, low e medium ficam na fronteira. O máximo fica atrás dela.
O outro 48 é uma nota de código
O Coding Agent Index v2.0 também marca o Terra em 48. Esse índice é FrontierCode, Terminal-Bench 4.0 e SWE-Atlas. Não é o Intelligence Index, mesmo com o número igual. O 48 do Terra aqui é no Codex. O Sol no Codex marca 54. A Luna no Codex marca 31. Os modelos da Claude no mesmo gráfico estão no Claude Code. Um 48 no Codex não passa uma nota do Claude Code, e não significa que a nota de inteligência e a nota de código sejam o mesmo resultado.
A fronteira vira. Neste gráfico de código, low e xhigh são os ajustes na linha de custo. Medium, high e max ficam atrás. No gráfico de inteligência, low e medium eram a fronteira, e o xhigh não era. O ajuste barato de código e o ajuste barato geral não são o mesmo controle.
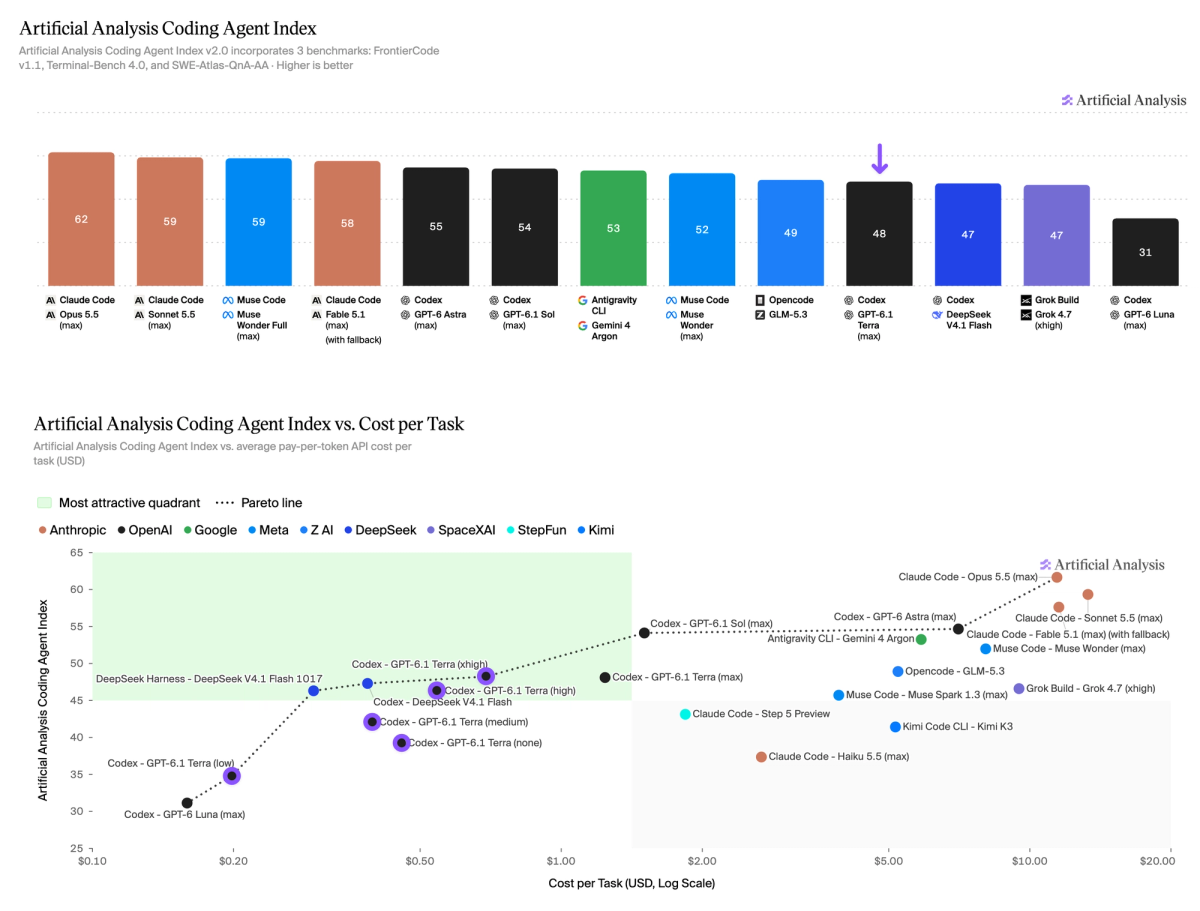
Artificial Analysis. O Terra no máximo marca 48 no Codex, seis pontos atrás do Sol no Codex. Low e xhigh são os pontos nesta fronteira de custo.
A linha de código da própria OpenAI é mais estreita, e concorda com o ranking. No máximo, no Terminal-Bench 4.0 da OpenAI, o Terra resolve 50,3% das tarefas, mais que o dobro dos 21,5% do GPT-5.6 Terra. A OpenAI diz que Sol e Astra continuam a melhor escolha para o código mais difícil. No Terminal-Bench-Science 0.1, a OpenAI diz que o Terra no máximo passa o Sol a um custo menor e fica a até cinco pontos do Opus 5.5, a menos de um quinto do custo estimado. Essas são as rodadas da OpenAI. Não são o gráfico da Artificial Analysis.
Nesse gráfico, o ganho do Terra é de cerca de 20 pontos, no nível do Sol no máximo. O Kimi K3.1 Pro lidera, com 67%.
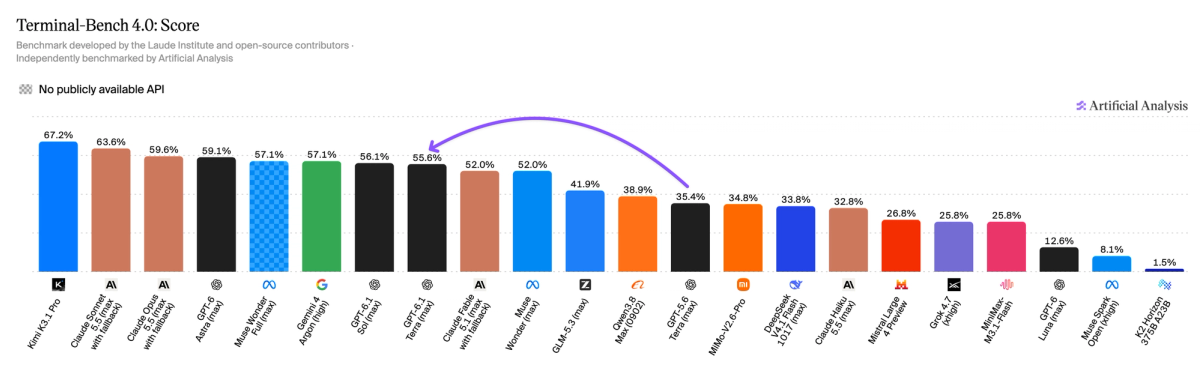
Artificial Analysis. O Terra fica ao lado do Sol. O Kimi K3.1 Pro lidera. O GPT-5.6 Terra fica bem atrás.
O uso de computador é a tese do lançamento, e ele está no medium
O caso da OpenAI para o Terra não é o índice. É uso de computador: transformar um desenho em modelo, percorrer um app de desktop, registrar um filme plano a plano. A comparação publicada ali é em esforço medium, no Agents' Last Exam. O Terra marca 15 pontos acima do GPT-5.6 Terra a cerca de um terço do custo, e a OpenAI o coloca no nível do Astra a um décimo do preço do token. No máximo, a OpenAI diz que o Terra é mais de três vezes mais eficiente em tokens do que o Opus 5.5, a um quarto do preço por token, o que eles juntam em cerca de nove vezes menos custo por tarefa. Também dizem que as tarefas terminam mais de três vezes mais rápido do que no Astra e no Sol.
O post não publica a nota do Agents' Last Exam por baixo dessa diferença de 15 pontos. O OSWorld 2.1, no medium, é descrito do mesmo jeito: à frente da melhor nota do GPT-5.6 Terra, a uma fração do custo, sem percentual no post. No MMMU-Pro, raciocínio visual, o Terra supera o GPT-5.6 Terra em todos os esforços que a OpenAI mostra, e eles dizem que chega perto do Astra e do Sol. De novo, sem percentual no post.
Trate esse bloco como o relato da OpenAI sobre o trabalho para o qual o Terra existe. O número independente ao lado continua sendo o índice: medium é 41 a US$ 0,10, e esse é o esforço que a OpenAI usou na comparação de uso de computador.
Ele inventa menos, em dois testes diferentes
No AA-Omniscience, a taxa de alucinação cai de 88% no GPT-5.6 Terra para 38%. A precisão sobe 2 pontos. O GDP.pdf, dentro do índice, move 5 pontos. A maior parte das outras avaliações do índice move menos do que o Terminal-Bench.
A OpenAI tem um segundo conjunto de factualidade, interno, feito de prompts que tendem a induzir erro. No esforço low, a taxa de erro cai de 53,6% para 16,7%. No máximo, cai 18 pontos, para 4,3%, que a OpenAI coloca ao lado do Astra e do Sol. Esses 4,3% não são os 38%. Um é o conjunto de erro da OpenAI. O outro é a taxa da Artificial Analysis de chute quando o modelo não sabe.
A OpenAI também diz que o Terra é mais propenso do que o GPT-5.6 Terra a ficar dentro da tarefa e a dizer quando algo está bloqueando, e que resiste a prompt injection nos testes deles. Em cybersecurity, ele atinge o limiar Critical no Preparedness Framework da OpenAI, com a mesma classe de proteções do Astra. Isso é uma classificação, não um modo de fazer.
Na prática
- Chame gpt-6.1-terra quando o trabalho é uso de computador e documento repetidos, e o preço do token importa. O preço de lista é US$ 1, US$ 0,05 em cache e US$ 5. A escrita de cache custa US$ 1,25. O Sol continua em US$ 2 e US$ 10.
- Use medium para a tese de uso de computador que a OpenAI está fazendo. Essa comparação é 15 pontos acima do GPT-5.6 Terra a cerca de um terço do custo. Medium no índice é 41, a US$ 0,10 por tarefa. Low é 36, a US$ 0,05. Esses dois são os que ficam na fronteira de inteligência e custo.
- Leia o máximo como 48, quatro pontos atrás do Sol, a US$ 0,40 por tarefa. São 6 pontos acima do GPT-5.6 Terra e menos de um terço dos US$ 1,40 daquele modelo. High é 44 a US$ 0,13. Xhigh é 45 a US$ 0,19. No gráfico de inteligência, esses três ficam atrás da fronteira.
- Em agentes de código, separe o controle. Low e xhigh são os ajustes de fronteira no Coding Agent Index. O 48 do Terra ali é Codex, seis pontos atrás dos 54 do Sol no Codex. O Terminal-Bench da própria OpenAI no máximo é 50,3%, contra 21,5% do GPT-5.6 Terra. A Artificial Analysis coloca o Terra ao lado do Sol, com o Kimi K3.1 Pro em 67% à frente dos dois. Para o código mais difícil, a OpenAI ainda aponta Sol e Astra.
- Mantenha os números de factualidade cada um no seu teste. A alucinação no Omniscience é 38%, vinda de 88%, com a precisão 2 pontos acima. A taxa de erro interna da OpenAI é 16,7% no low e 4,3% no máximo.
- Um prompt longo na Bedrock muda o preço. Até 272.000 tokens de entrada, a tarifa global acompanha a OpenAI. Acima disso, a Bedrock sobe. O contexto que a Bedrock lista é de 1.050.000 tokens, com 128.000 tokens de saída máxima.
Fontes: Introducing GPT-6.1 Terra, a Artificial Analysis e o model card da Bedrock. A escada do índice, a tarefa de US$ 0,40, o Coding Agent Index, as taxas de Omniscience e o gráfico de Terminal-Bench são da Artificial Analysis. O preço de US$ 1 / US$ 0,05 / US$ 5, a comparação do Agents' Last Exam, o Terminal-Bench de 50,3%, o Terminal-Bench-Science, o MMMU-Pro, o OSWorld e as taxas de erro internas são da OpenAI. A janela de 1.050.000 tokens e o degrau de preço da Bedrock são da AWS.
