A Meta lançou dois modelos em 12 de outubro de 2026. O mais forte é o Muse Wonder Full. Ele entra pela assinatura do Muse Code: Power a US$ 50 por mês, ou Maximum a US$ 200. Esse modelo não é vendido por token.
O modelo da API é o outro. O id é muse-wonder-1.0, a US$ 4 por milhão de tokens de entrada, US$ 0,20 em cache e US$ 20 de saída. É o preço de lista do Opus. O Muse Spark 1.3, seis semanas antes, custava US$ 1,25, US$ 0,15 e US$ 4,25.
No Intelligence Index da Artificial Analysis, no esforço máximo, o modelo da assinatura marca 56. O modelo da API marca 52. O Opus 5.5 ainda lidera esse gráfico, em 58. O Sonnet 5.5 no máximo também marca 56. O Astra marca 53. O GPT-6.1 Sol no máximo marca 52, o mesmo índice do modelo da API.
Os dois recebem texto, imagem, vídeo e áudio, e devolvem texto. O contexto é de 1 milhão de tokens, a mesma janela do Spark 1.3. As comparações publicadas pela Meta usam esforço máximo. No SWE-Marathon, o resultado do Full que a Meta cita é xhigh, e essa linha não é um harness compartilhado. Recusas ficam no denominador como zero. A barra do Full no gráfico do índice está marcada como sem API pública.
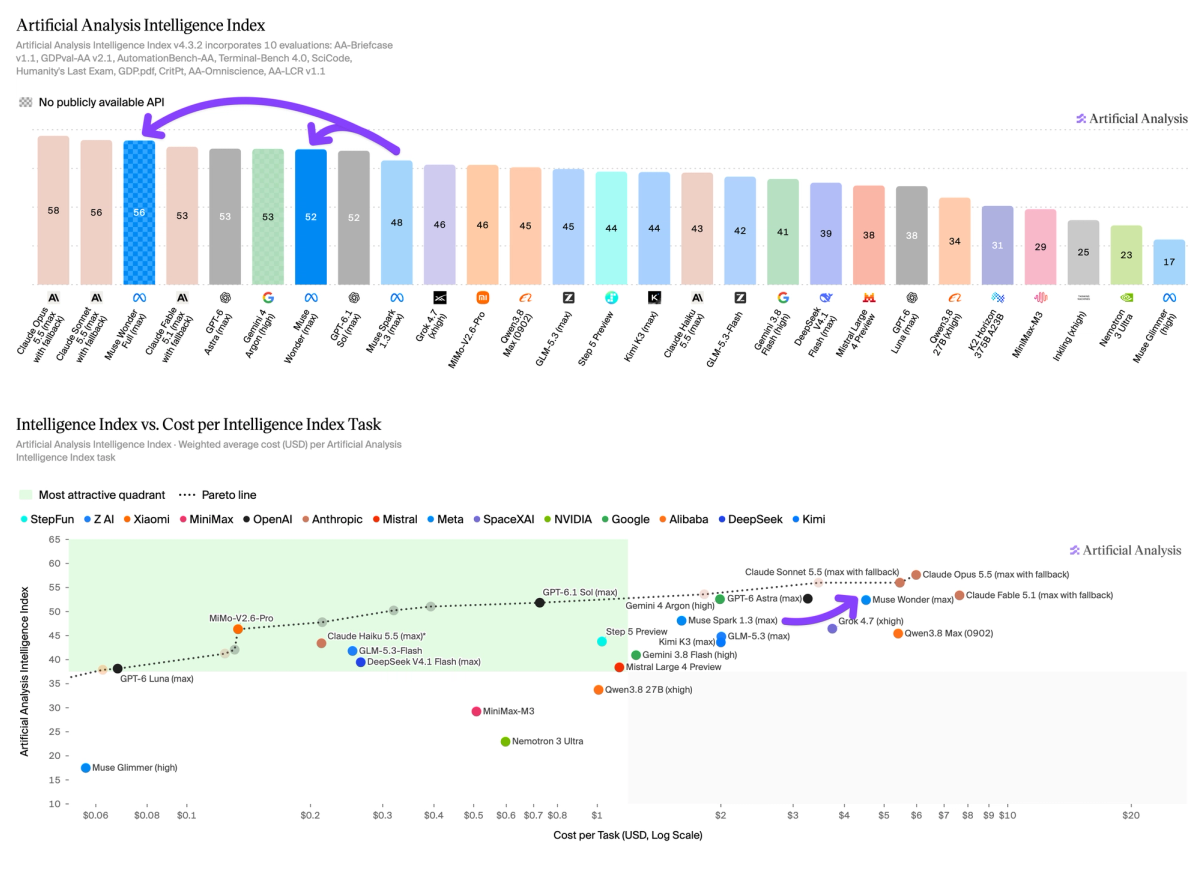
Artificial Analysis. O modelo da assinatura marca 56 e não tem API pública. O modelo da API marca 52. No gráfico de custo, esse modelo da API fica à direita do Astra e bem à direita do GPT-6.1 Sol.
O que a assinatura compra em relação ao Spark
O Spark 1.3 no máximo marcava 48. O Full ganha 8 pontos, e ganha em cada uma das dez avaliações do índice. O modelo da API ganha 4.
O maior movimento é o Terminal-Bench 4.0. O Spark marcava 33%. O modelo da API marca 52%. O Full marca 57%, no nível do Gemini 4 Argon em high. No AutomationBench-AA, o Spark marcava 58%, o modelo da API marca 68% e o Full marca 71%.
Em trabalho de conhecimento, o Full é o que muda o ranking. O GDPval-AA v2.1 vai de 1681 Elo para 1857, um ganho de 176. Esse 1857 fica dentro do intervalo de confiança do Opus 5.5 no máximo com fallback, 1866, e do Sonnet 5.5 no máximo com fallback, 1838. O AA-Briefcase vai de 1581 para 1729, um ganho de 148. O Full é terceiro ali, e terceiro no AutomationBench.
Ele é primeiro em dois quadros estreitos, por uma margem pequena. O CritPt marca 33%, com os modelos seguintes entre 31% e 32%. O GDP.pdf marca 33%, o mesmo tipo de liderança. O SciCode marca 63%, em terceiro. Essas são as rodadas da Artificial Analysis. A Meta também publica um GDP.pdf da Surge. Esse número fica na coluna da Meta. É uma medição diferente deste 33%.
No modelo da API, a maior parte da conta vai para a entrada
Os dois modelos usam cerca de 54.000 tokens de saída por tarefa do índice, cerca de 10% a menos que os 60.000 do Spark. É menos que o Gemini 4 Argon em high, cerca de 62.000, e menos que o Fable 5.1 no máximo com fallback, cerca de 78.000. É mais que o GPT-6.1 Sol no máximo, cerca de 38.000, e mais que o Astra no máximo, cerca de 27.000.
O Full é o mais econômico dos dois na entrada: 6,44 milhões de tokens de entrada por tarefa, contra 7,69 milhões do modelo da API, cerca de 16% a menos. Os 7,69 milhões do modelo da API são 28% mais entrada do que o Spark usou. A saída ficou um pouco mais curta. A entrada, no modelo que dá para chamar, ficou mais longa, a um preço de token bem mais alto.
Uma tarefa do índice no modelo da API custa US$ 4,52. Isso é 2,8 vezes os US$ 1,60 do Spark. Entrada e cache são US$ 3,43 disso, 76%: US$ 1,92 de escrita de cache, US$ 1,44 de acerto de cache e US$ 0,07 de entrada sem cache. A saída fica em cerca de US$ 1,08. O Full não tem preço por token, então a Artificial Analysis não publica um custo por tarefa para o modelo da assinatura.
Esses US$ 4,52 ficam acima dos US$ 3,26 do Astra, e o Astra marca um ponto a mais. Ficam bem acima dos US$ 0,72 do GPT-6.1 Sol, no mesmo índice de 52. Ficam abaixo do Sonnet no máximo com fallback, US$ 5,46, do Opus no máximo com fallback, US$ 5,98, e do Fable 5.1 no máximo com fallback, US$ 7,63.
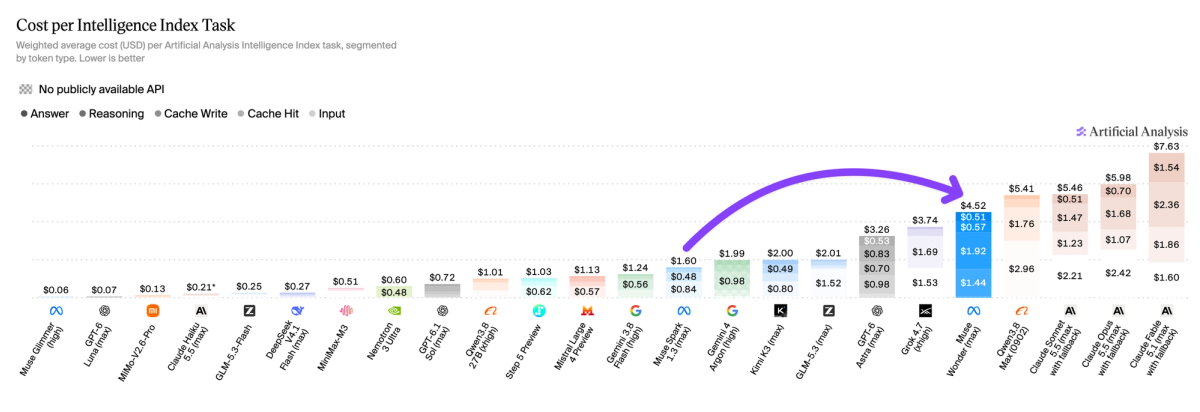
Artificial Analysis. O modelo da API custa US$ 4,52 por tarefa. Os segmentos azuis são escrita e acerto de cache. O modelo da assinatura não aparece, porque não tem preço por token.
Conhecimento continua sendo o quadro fraco
No AA-Omniscience, o Full marca 30 e o modelo da API marca 25, no nível do Spark 1.3 no máximo. O Opus marca 46. O Astra marca 43. O Gemini 4 Argon em high marca 42. O Sonnet 5.5 marca 32. O ganho do Full no índice é uma taxa de alucinação mais baixa, de 33% para 23%. Entre os modelos com 45 ou mais no Intelligence Index, esses 23% ficam em segundo, atrás só do Argon em high, em 15%. O modelo da API é o terceiro, em 27%.
O modelo da assinatura sabe menos que os modelos ao redor dele no gráfico de inteligência, e inventa menos do que o Spark inventava.
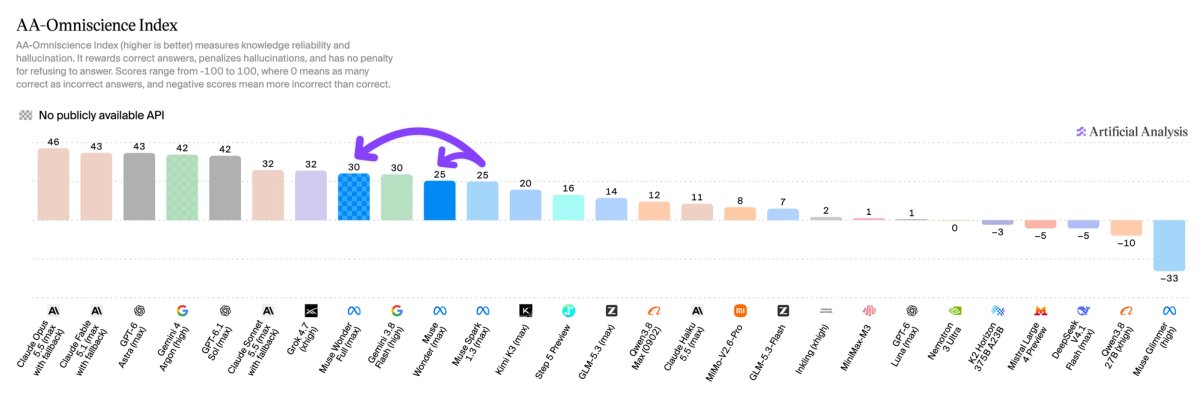
Artificial Analysis. O Full marca 30. O modelo da API e o Spark 1.3 marcam 25. Opus, Astra e Argon ficam acima.
Agentes de código, por harness
No Coding Agents Index, o Full no máximo no Muse Code marca 68. O Sonnet 5.5 no máximo no Claude Code também marca 68. O Opus 5.5 no máximo no Claude Code marca 66. O modelo da API no máximo marca 63. O Spark 1.3 no máximo no Muse Code marcava 54. Um 68 no Muse Code e um 68 no Claude Code são o mesmo número em dois harnesses. Leia isso como um empate no gráfico que a Artificial Analysis desenha.
Os nomes da Meta para o comportamento do produto são Active Memory e Active Focus: carregar contexto entre conversas, continuar quando a tarefa trava, perguntar antes de uma ação relevante. Os números independentes que se moveram são os de agente, acima. O MemoryBench e o FocusBench da própria Meta são internos, e não são o índice.
Na prática
- Assine o Muse Code para o modelo mais forte. Esse é o Muse Wonder Full, nos planos de US$ 50 e US$ 200. Ele não tem preço por token, então os US$ 4,52 não se aplicam a ele.
- Chame muse-wonder-1.0 quando precisar da API. Essa nota é 52. O 56 fica dentro da assinatura.
- O salto de seis semanas apareceu nos agentes. O Terminal-Bench foi de 33% para 52% no modelo da API e para 57% no Full. O movimento do Full no GDPval é de 1681 para 1857 Elo, dentro da faixa do Opus e do Sonnet nesta rodada. O Briefcase foi de 1581 para 1729.
- Para um modelo chamável no índice 52, o máximo do GPT-6.1 Sol é a mesma nota a US$ 0,72 por tarefa. O máximo do Astra é 53 a US$ 3,26. O máximo do modelo da API é US$ 4,52, e três quartos disso são entrada e cache.
- Em agentes de código, o 68 do Full é Muse Code e o 68 do Sonnet é Claude Code. O modelo da API marca 63. O Spark no Muse Code marcava 54.
- Espere uma nota de conhecimento mais fraca do que o índice sugere. O Omniscience é 30 para o Full e 25 para o modelo da API, com alucinação em 23% e 27%.
- Mantenha a tabela de lançamento da Meta na coluna dela. Essas células são esforço máximo, exceto o número do Full no SWE-Marathon, que é xhigh. Quando uma célula da Meta e uma da Artificial Analysis compartilham o nome e discordam, são duas medições.
Fontes: Muse Wonder, o model card, a página do modelo da Meta, a Artificial Analysis e a OpenRouter. O índice de 56 e 52, o Terminal-Bench, o GDPval, o Briefcase, as contagens de tokens e a tarefa de US$ 4,52 são da Artificial Analysis, em esforço máximo. O id da API, o preço de US$ 4 / US$ 0,20 / US$ 20 e os planos do Muse Code são da Meta.