Meta lanzó dos modelos el 12 de octubre de 2026. El más fuerte es Muse Wonder Full. Entra con la suscripción de Muse Code: Power a US$ 50 al mes, o Maximum a US$ 200. Ese modelo no se vende por token.
El modelo de la API es el otro. El id es muse-wonder-1.0, a US$ 4 por millón de tokens de entrada, US$ 0,20 en caché y US$ 20 de salida. Es el precio de lista de Opus. Muse Spark 1.3, seis semanas antes, costaba US$ 1,25, US$ 0,15 y US$ 4,25.
En el Intelligence Index de Artificial Analysis, con esfuerzo máximo, el modelo de la suscripción marca 56. El modelo de la API marca 52. Opus 5.5 sigue liderando ese gráfico, en 58. Sonnet 5.5 al máximo también marca 56. Astra marca 53. GPT-6.1 Sol al máximo marca 52, el mismo índice del modelo de la API.
Los dos reciben texto, imagen, vídeo y audio, y devuelven texto. El contexto es de 1 millón de tokens, la misma ventana de Spark 1.3. Las comparaciones publicadas por Meta usan esfuerzo máximo. En SWE-Marathon, el resultado de Full que cita Meta es xhigh, y esa fila no es un harness compartido. Los rechazos se quedan en el denominador como cero. La barra de Full en el gráfico del índice está marcada como sin API pública.
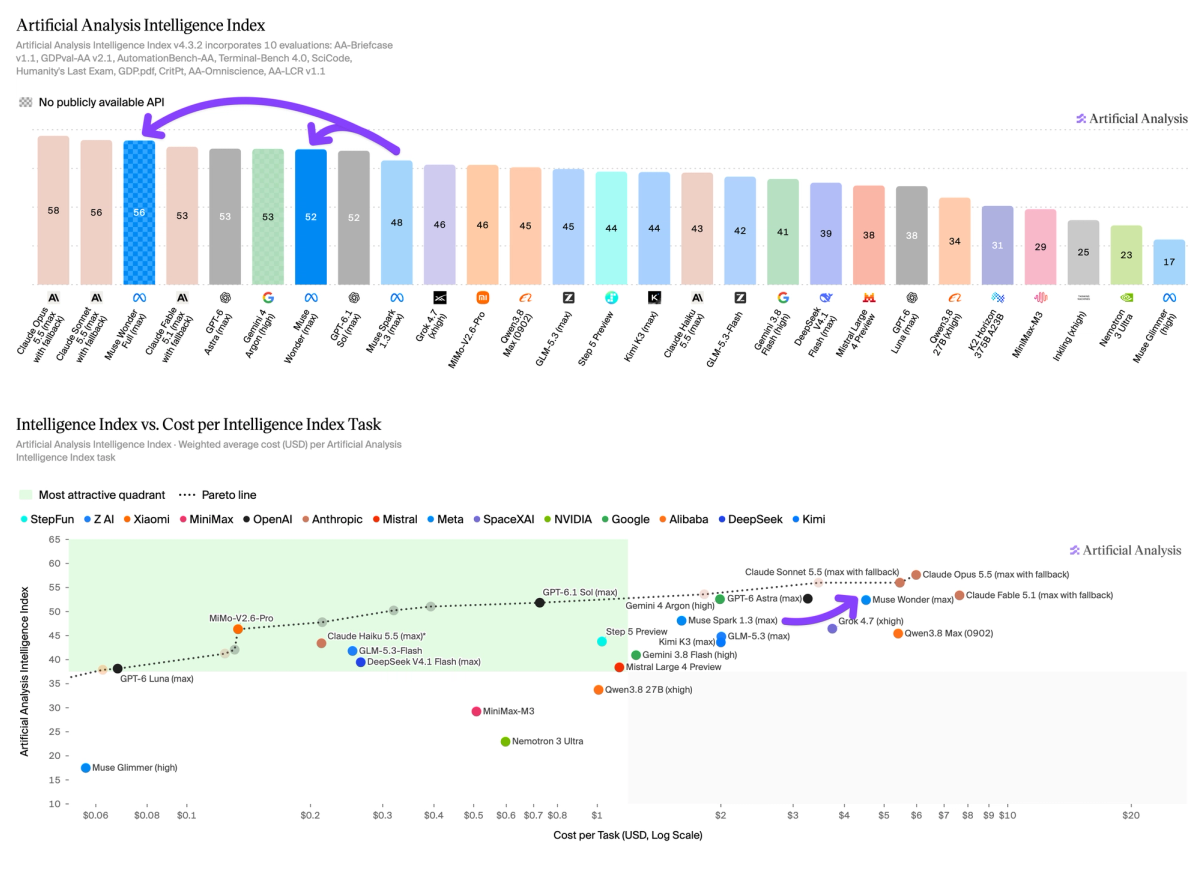
Artificial Analysis. El modelo de la suscripción marca 56 y no tiene API pública. El modelo de la API marca 52. En el gráfico de coste, ese modelo de la API queda a la derecha de Astra y bastante a la derecha de GPT-6.1 Sol.
Lo que la suscripción compra respecto a Spark
Spark 1.3 al máximo marcaba 48. Full gana 8 puntos, y los gana en cada una de las diez evaluaciones del índice. El modelo de la API gana 4.
El mayor movimiento es Terminal-Bench 4.0. Spark marcaba 33%. El modelo de la API marca 52%. Full marca 57%, al nivel de Gemini 4 Argon en high. En AutomationBench-AA, Spark marcaba 58%, el modelo de la API marca 68% y Full marca 71%.
En trabajo de conocimiento, Full es el que cambia el ranking. GDPval-AA v2.1 pasa de 1681 Elo a 1857, una ganancia de 176. Ese 1857 queda dentro del intervalo de confianza de Opus 5.5 al máximo con fallback, 1866, y de Sonnet 5.5 al máximo con fallback, 1838. AA-Briefcase pasa de 1581 a 1729, una ganancia de 148. Full es tercero ahí, y tercero en AutomationBench.
Es primero en dos tableros estrechos, por un margen pequeño. CritPt marca 33%, con los modelos siguientes entre 31% y 32%. GDP.pdf marca 33%, el mismo tipo de ventaja. SciCode marca 63%, en tercero. Esas son las pasadas de Artificial Analysis. Meta también publica un GDP.pdf de Surge. Esa cifra se queda en la columna de Meta. Es una medición distinta de este 33%.
En el modelo de la API, la mayor parte de la factura va a la entrada
Los dos modelos usan unos 54.000 tokens de salida por tarea del índice, cerca de un 10% menos que los 60.000 de Spark. Es menos que Gemini 4 Argon en high, unos 62.000, y menos que Fable 5.1 al máximo con fallback, unos 78.000. Es más que GPT-6.1 Sol al máximo, unos 38.000, y más que Astra al máximo, unos 27.000.
Full es el más económico de los dos en la entrada: 6,44 millones de tokens de entrada por tarea, frente a 7,69 millones del modelo de la API, cerca de un 16% menos. Los 7,69 millones del modelo de la API son un 28% más de entrada de la que usó Spark. La salida quedó un poco más corta. La entrada, en el modelo que se puede llamar, quedó más larga, a un precio de token mucho más alto.
Una tarea del índice en el modelo de la API cuesta US$ 4,52. Eso es 2,8 veces los US$ 1,60 de Spark. Entrada y caché son US$ 3,43 de eso, el 76%: US$ 1,92 de escritura de caché, US$ 1,44 de acierto de caché y US$ 0,07 de entrada sin caché. La salida queda en unos US$ 1,08. Full no tiene precio por token, así que Artificial Analysis no publica un coste por tarea para el modelo de la suscripción.
Esos US$ 4,52 quedan por encima de los US$ 3,26 de Astra, y Astra marca un punto más. Quedan bastante por encima de los US$ 0,72 de GPT-6.1 Sol, en el mismo índice de 52. Quedan por debajo de Sonnet al máximo con fallback, US$ 5,46, de Opus al máximo con fallback, US$ 5,98, y de Fable 5.1 al máximo con fallback, US$ 7,63.
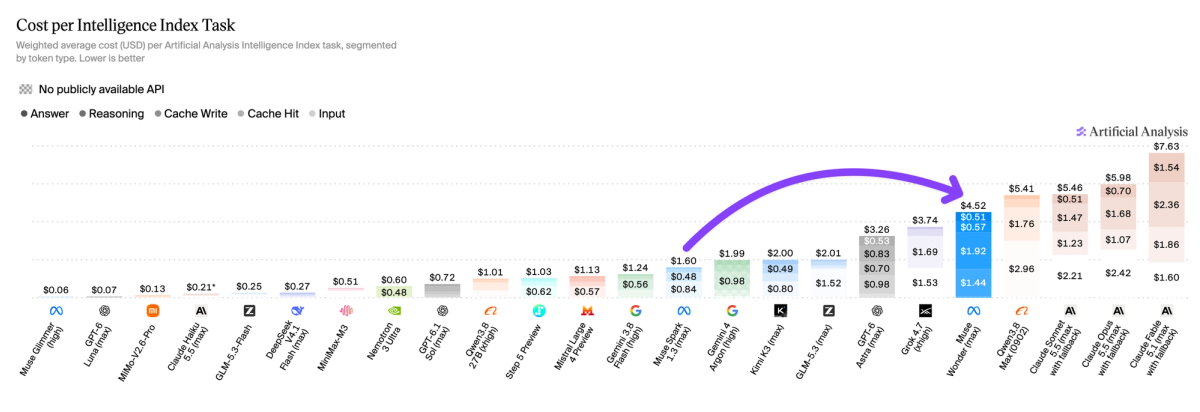
Artificial Analysis. El modelo de la API cuesta US$ 4,52 por tarea. Los segmentos azules son escritura y acierto de caché. El modelo de la suscripción no aparece, porque no tiene precio por token.
El conocimiento sigue siendo el tablero débil
En AA-Omniscience, Full marca 30 y el modelo de la API marca 25, al nivel de Spark 1.3 al máximo. Opus marca 46. Astra marca 43. Gemini 4 Argon en high marca 42. Sonnet 5.5 marca 32. La ganancia de Full en el índice es una tasa de alucinación más baja, del 33% al 23%. Entre los modelos con 45 o más en el Intelligence Index, ese 23% queda segundo, solo detrás de Argon en high, en 15%. El modelo de la API es el tercero, en 27%.
El modelo de la suscripción sabe menos que los modelos a su alrededor en el gráfico de inteligencia, e inventa menos de lo que inventaba Spark.
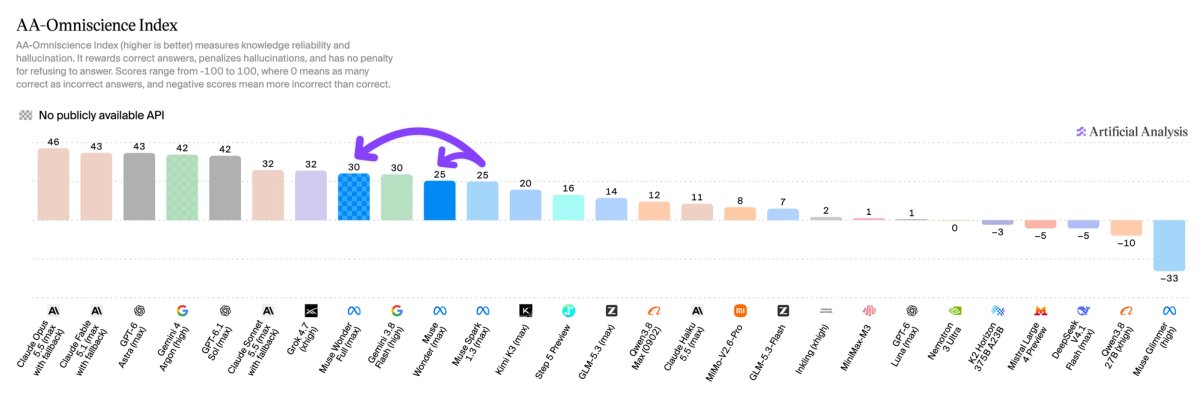
Artificial Analysis. Full marca 30. El modelo de la API y Spark 1.3 marcan 25. Opus, Astra y Argon quedan por encima.
Agentes de código, por harness
En el Coding Agents Index, Full al máximo en Muse Code marca 68. Sonnet 5.5 al máximo en Claude Code también marca 68. Opus 5.5 al máximo en Claude Code marca 66. El modelo de la API al máximo marca 63. Spark 1.3 al máximo en Muse Code marcaba 54. Un 68 en Muse Code y un 68 en Claude Code son el mismo número en dos harnesses. Léelo como un empate en el gráfico que dibuja Artificial Analysis.
Los nombres de Meta para el comportamiento del producto son Active Memory y Active Focus: llevar contexto entre conversaciones, seguir cuando la tarea se traba, preguntar antes de una acción relevante. Los números independientes que se movieron son los de agente, arriba. MemoryBench y FocusBench de la propia Meta son internos, y no son el índice.
En la práctica
- Suscríbete a Muse Code para el modelo más fuerte. Ese es Muse Wonder Full, en los planes de US$ 50 y US$ 200. No tiene precio por token, así que los US$ 4,52 no se le aplican.
- Llama a muse-wonder-1.0 cuando necesites la API. Esa nota es 52. El 56 se queda dentro de la suscripción.
- El salto de seis semanas apareció en los agentes. Terminal-Bench pasó del 33% al 52% en el modelo de la API y al 57% en Full. El movimiento de Full en GDPval es de 1681 a 1857 Elo, dentro de la franja de Opus y Sonnet en esta pasada. Briefcase pasó de 1581 a 1729.
- Para un modelo que se puede llamar en el índice 52, el máximo de GPT-6.1 Sol es la misma nota a US$ 0,72 por tarea. El máximo de Astra es 53 a US$ 3,26. El máximo del modelo de la API es US$ 4,52, y tres cuartos de eso son entrada y caché.
- En agentes de código, el 68 de Full es Muse Code y el 68 de Sonnet es Claude Code. El modelo de la API marca 63. Spark en Muse Code marcaba 54.
- Espera una nota de conocimiento más débil de lo que sugiere el índice. Omniscience es 30 para Full y 25 para el modelo de la API, con alucinación en 23% y 27%.
- Mantén la tabla de lanzamiento de Meta en su columna. Esas celdas son esfuerzo máximo, salvo la cifra de Full en SWE-Marathon, que es xhigh. Cuando una celda de Meta y una de Artificial Analysis comparten el nombre y no coinciden, son dos mediciones.
Fuentes: Muse Wonder, la model card, la página del modelo de Meta, Artificial Analysis y OpenRouter. El índice de 56 y 52, Terminal-Bench, GDPval, Briefcase, los recuentos de tokens y la tarea de US$ 4,52 son de Artificial Analysis, con esfuerzo máximo. El id de la API, el precio de US$ 4 / US$ 0,20 / US$ 20 y los planes de Muse Code son de Meta.