Claude Haiku 5.5 salió el 7 de octubre de 2026. Es el primer Haiku con ajuste de esfuerzo. Deja ese control quieto y recibes medium. En el Intelligence Index de Artificial Analysis, medium marca 34. La versión de los materiales de lanzamiento es max, y max marca 43.
Esos 43 son 26 puntos por encima de Haiku 4.5, que está en 17, y 13 puntos por detrás de Sonnet 5.5 al máximo, que marca 56. La tabla de lanzamiento no nombra el esfuerzo en las celdas de Haiku. Una nota de Briefcase o de uso del ordenador en esa tabla es un resultado publicado. Es lo alto de la escalera. De fábrica, estás dos peldaños más abajo.
En la API el id es claude-haiku-5-5. El contexto es de 1 millón de tokens, por encima de los 200.000. La salida máxima es de 128.000, por encima de los 64.000. La entrada es texto e imagen. La salida es texto. El corte de conocimiento fiable es junio de 2026. El adaptive thinking viene encendido. El mismo texto cuenta como cerca de un 30% más de tokens que en Haiku 4.5, así que un max_tokens calibrado para el modelo anterior puede parar después del pensamiento y antes de la respuesta.
La versión del lanzamiento es lo alto de la escalera
Artificial Analysis ejecutó los cinco esfuerzos. High, en 38, es el máximo de GPT-6 Luna. Max, en 43, queda justo por delante de GLM-5.3 Flash en 42 y de Gemini 3.8 Flash en 41, y justo por detrás de Kimi K3 en 44.
| Esfuerzo | Intelligence Index |
|---|---|
| Low | 29 |
| Medium | 34 |
| High | 38 |
| Xhigh | 41 |
| Max | 43 |
Los tokens deciden si la versión del lanzamiento merece encenderse. En max, una tarea del índice usa unos 162.000 tokens de salida, cerca de tres veces el máximo de Luna, y más que Opus 5.5 al máximo. La mayor parte de eso es razonamiento. El paso de xhigh en 41 a max en 43 son 2 puntos por cerca de 1,8 veces los tokens. High llega a los 38 de Luna con unos 55.000 tokens de salida, frente a unos 50.000 de Luna. La pasada completa del índice en max produjo 440 millones de tokens de salida, frente a una mediana de 100 millones. La pasada de low produjo 32 millones.
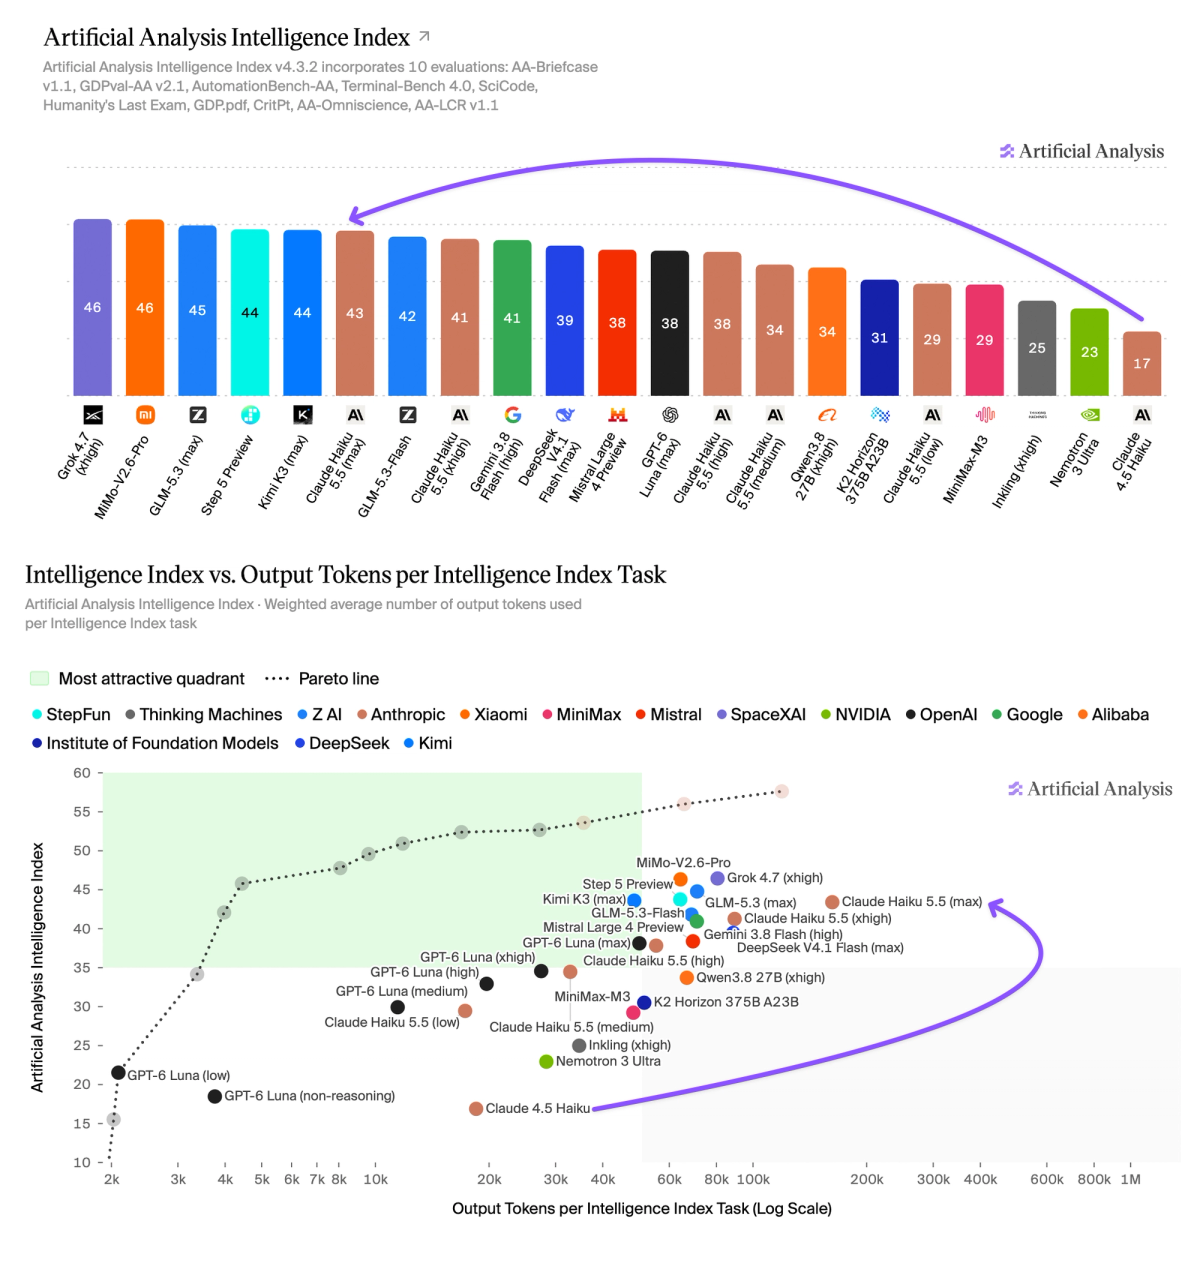
Artificial Analysis. Max marca 43, 26 puntos por encima de Haiku 4.5. En el gráfico de tokens, max queda bien a la derecha de Luna.
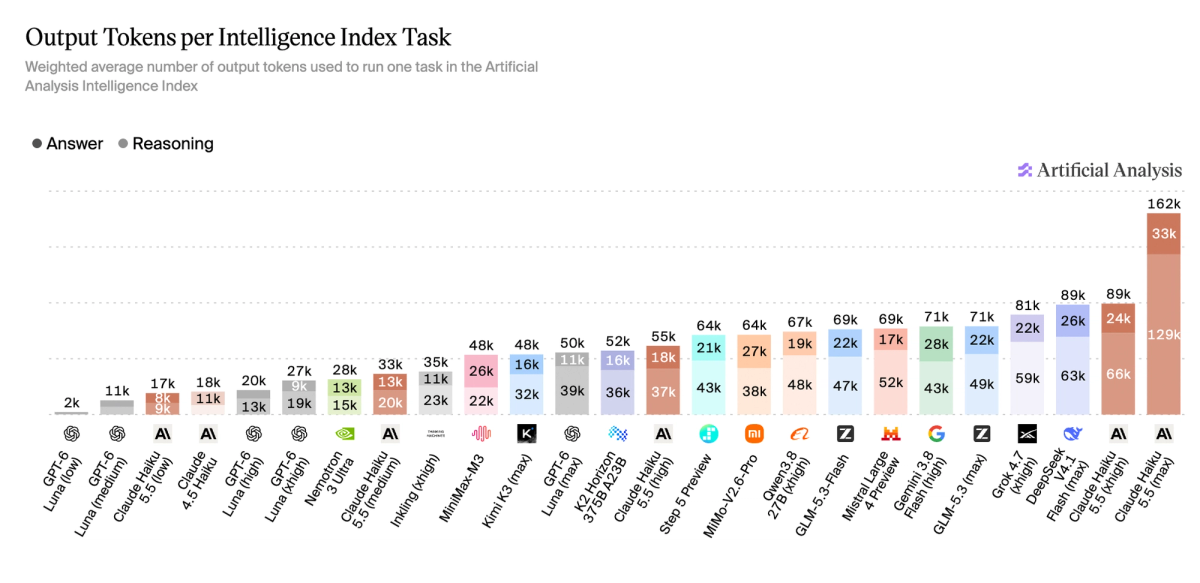
Artificial Analysis. Max usa unos 162.000 tokens de salida por tarea. La mayor parte de esa barra es razonamiento.
Dónde la versión del lanzamiento se gana los tokens de más
En AA-Briefcase, Anthropic y Artificial Analysis publican 1578 Elo. Haiku 4.5 marca 614. Luna marca 1336. Sonnet, en la tabla de Anthropic, marca 1824. Artificial Analysis sitúa 1578 dentro del intervalo de confianza de Astra al máximo y de Fable 5.1 en high, y al lado de Muse Spark 1.3 al máximo. Esos 1578 son la versión del lanzamiento. Medium es un peldaño más bajo en el mismo gráfico.
En AA-Omniscience el modelo sabe menos e inventa menos. La precisión es 36%, frente a 55% de Gemini 3.8 Flash y 44% de Luna. La tasa de alucinación es 40%, frente a 55% y 77%. Parte del fallo es el modelo diciendo que no sabe.
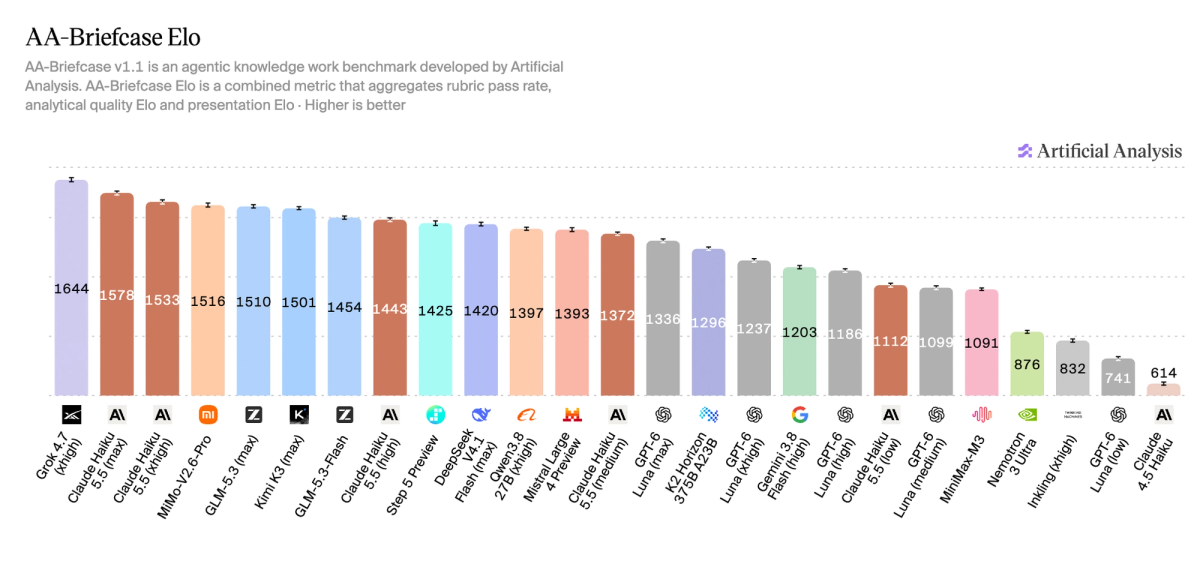
Artificial Analysis. Haiku 5.5 al máximo marca 1578 Elo. Haiku 4.5 marca 614. El máximo de Luna en este gráfico es 1336.
La tabla de lanzamiento de Anthropic es una segunda fuente, y sigue sin nombrar el esfuerzo de Haiku. Mantén esa tabla aparte de la escalera de arriba.
En Terminal-Bench 4.0, Anthropic reporta 39,2% para Haiku 5.5, 0,0% para Haiku 4.5, 16,4% para Luna y 70,6% para Sonnet. Artificial Analysis, en su propia pasada, reporta cerca de 33%, al nivel de GLM-5.3 Flash, por delante de Gemini 3.8 Flash en 20% y de Luna en 13%, y otra vez 0% para Haiku 4.5. Son dos harnesses. El 0% es un suelo. La ventaja de Sonnet es el reparto que decide adónde va el trabajo difícil de terminal.
En FrontierCode 1.1 Main, Anthropic reporta 46,4% para Haiku, 42,4% para Luna y 52,1% para Sonnet en xhigh. Solo la celda de Sonnet está etiquetada. En OSWorld 2.1, subconjunto offline, Haiku marca 72,4%, Haiku 4.5 marca 15,7%, Luna marca 48,9% y Sonnet marca 83,9%. En Humanity's Last Exam, Haiku marca 45,9% sin herramientas y 57,4% con herramientas. Sonnet marca 56,9% y 64,5%. En Chartography sin herramientas, Haiku marca 46,4%, Haiku 4.5 marca 6,4%, Luna marca 29,1% y Sonnet marca 61,6%. En GDPval-AA v2.1, Haiku marca 1620, Haiku 4.5 marca 735, Luna marca 1437 y Sonnet marca 1840.
AutomationBench-AA pide una espera. Artificial Analysis mide 35%, frente a 53% a 60% de Luna, Gemini 3.8 Flash y GLM-5.3 Flash, y dice que un rechazo de seguridad de la versión previa al lanzamiento hizo que el modelo rechazara de más. Esperan una nota más alta en la nueva pasada.
El precio, después de elegir la versión
Por debajo de 100.000 tokens de entrada, Haiku 5.5 cuesta US$ 0,10 por millón de tokens de entrada y US$ 0,50 de salida. La lectura de caché cuesta US$ 0,01. La escritura de caché de cinco minutos cuesta US$ 0,125. Ese precio de lista empata con Luna, y queda un 90% por debajo de Haiku 4.5, a US$ 1 y US$ 5. Por encima de 100.000 tokens de entrada, la request entera cuesta cinco veces eso: US$ 0,50, US$ 2,50, lectura de caché a US$ 0,05, escritura de caché a US$ 0,625. Anthropic dice que cerca del 90% de las requests al Haiku anterior quedaban por debajo de la línea, y que una mezcla típica ahora cuesta cerca de un 75% menos de ejecutar, tokenizer incluido.
Artificial Analysis puso precio a las tareas del índice solo en la tarifa más baja. Low cuesta US$ 0,02 por tarea y max cuesta US$ 0,21, con una distancia de hasta 8,7 veces entre los cinco esfuerzos. Esas cifras no incluyen el escalón de precio.
El mismo lanzamiento recorta la lectura de caché de Sonnet 5.5 de US$ 0,20 a US$ 0,10. La estimación de Anthropic es cerca de un 20% menos en la mayor parte del trabajo agéntico. La entrada y la salida de Sonnet siguen en US$ 2 y US$ 10. El modelo que todavía lidera Terminal-Bench quedó más barato de reutilizar el día en que llegó el modelo pequeño.
En la práctica
- De fábrica recibes medium, y medium marca 34. El 43, los 1578 de Briefcase y la línea de uso del ordenador en la tabla de lanzamiento son la versión que enciendes.
- Para un trabajo que tenga que empatar con Luna, usa high. Eso es 38, a unos 55.000 tokens de salida por tarea del índice. Max suma 2 puntos sobre xhigh y cerca de 1,8 veces los tokens, y una tarea llega a unos 162.000 tokens de salida.
- Deja Sonnet 5.5 en el trabajo difícil de terminal. El reparto de Anthropic es 70,6% frente a 39,2%. La lectura de caché de Sonnet ahora cuesta US$ 0,10. El 0% de Haiku 4.5 en este bench es un suelo, en la tabla de Anthropic y en la pasada de Artificial Analysis.
- Usa Haiku donde la tarea es estrecha y repetida: clasificación, extracción, compactación, enrutado y un subagente bajo un modelo mayor. Es la carga para la que se hizo la escalera de esfuerzo.
- Si un prompt pasa de 100.000 tokens de entrada, la request entera pasa a US$ 0,50 y US$ 2,50. Los precios de US$ 0,02 y US$ 0,21 por tarea son la tarifa más baja.
- Deja margen en max_tokens. El mismo texto tiene cerca de un 30% más de tokens que en Haiku 4.5, y el pensamiento cuenta en el límite. El pensamiento se puede apagar en low, medium y high. En xhigh y max esa request devuelve 400. Cambiar el esfuerzo entre turnos invalida la caché del prompt.
- Sostén AutomationBench en 35% hasta la nueva pasada. La nota publicada incluye rechazos de más.
Fuentes: Introducing Claude Haiku 5.5, Artificial Analysis, la comparación de esfuerzo y la visión general del modelo. La escalera del índice, la tarea de 162.000 tokens, Briefcase en 1578 y las tasas de Omniscience son de Artificial Analysis. La tabla de lanzamiento es de Anthropic, y no nombra el esfuerzo de Haiku. El medium por defecto y el cambio del 30% del tokenizer vienen de la documentación de Claude.